Welche Filterseite verdient einen Platz im Suchindex? Entscheidend sind Suchintention, ein passendes Sortiment und ein eigenständiger Nutzen. Dieser Leitfaden trennt indexierbare Facetten von Sortierungen und beliebigen Kombinationen und erklärt die passende technische Steuerung.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: SEO & Content →
Die Ära der Agentic Search Engines & KI-Scraper
Bei SEO Filternavigation lautet die erste Entscheidung: Soll diese gefilterte Produktliste über die Suche gefunden werden? Google empfiehlt, benötigte Filter-URLs gezielt crawlbar zu halten und das Crawling unnötiger Kombinationen zu begrenzen. Die folgende Entscheidungshilfe macht daraus eine Freigabeliste für Ihren Shop.
- Kombinatorische Explosion stoppen: Frei kombinierbare Filter erzeugen viele ähnliche URLs. Eine Freigabeliste begrenzt, welche davon Suchmaschinen entdecken sollen.
- Architektur-Trennung zwischen Inhalt & Zustand: SEO-starke Filterkombinationen (z. B. Marke + Farbe) erhalten feste, sprechende Clean URLs. Sortierungen und beliebige Kombinationen werden getrennt behandelt: Canonical für Duplikate, noindex für den Indexausschluss und robots.txt für die Crawl-Steuerung.
- Technologischer Schutzschirm: Indexierung und Crawling sind unterschiedliche Aufgaben. Eine per robots.txt gesperrte URL kann ihr noindex-Signal nicht an Google ausliefern.
- 1. SEO Filternavigation: Die Indexentscheidung
- 2. Das Kernproblem: Crawl-Budget-Verschwendung & Duplicate Content
- 3. Technische Lösungen für das Filter-Management
- 3.1 Entscheidungsmatrix für Facetten
- 3.2 Praxis in Shopware 6, Shopify & WooCommerce
- 4. Das PRG-Pattern: Filterinteraktion und URL-Steuerung
- 5. Link-Attribute & Dofollow/Nofollow Strategien
- 6. Roadmap: Shop-Audit & Implementierung
- 7. Best Practices für die URL-Struktur im E-Commerce
- 8. Häufig gestellte Fragen (Glossar)
1. SEO Filternavigation: Die Indexentscheidung
Wer im modernen E-Commerce nachhaltig profitabel wachsen will, muss seinen Kunden eine kompromisslos schnelle und intuitive User Experience (UX) bieten. Ein zentrales Herzstück dieser Einkaufserfahrung ist die sogenannte Faceted Navigation (im deutschen Sprachraum meist als Facettennavigation oder Mehrfach-Filtersystem bezeichnet). Kunden erwarten heute selbstverständlich, dass sie Kataloge mit zehntausenden Artikeln in Sekundenschnelle nach Attributen wie Größe, Farbe, Marke, Material, Preisspanne oder Verfügbarkeit eingrenzen können. Aus Sicht der Conversion-Optimierung ist ein solches Filtersystem ein unverzichtbarer Umsatztreiber.
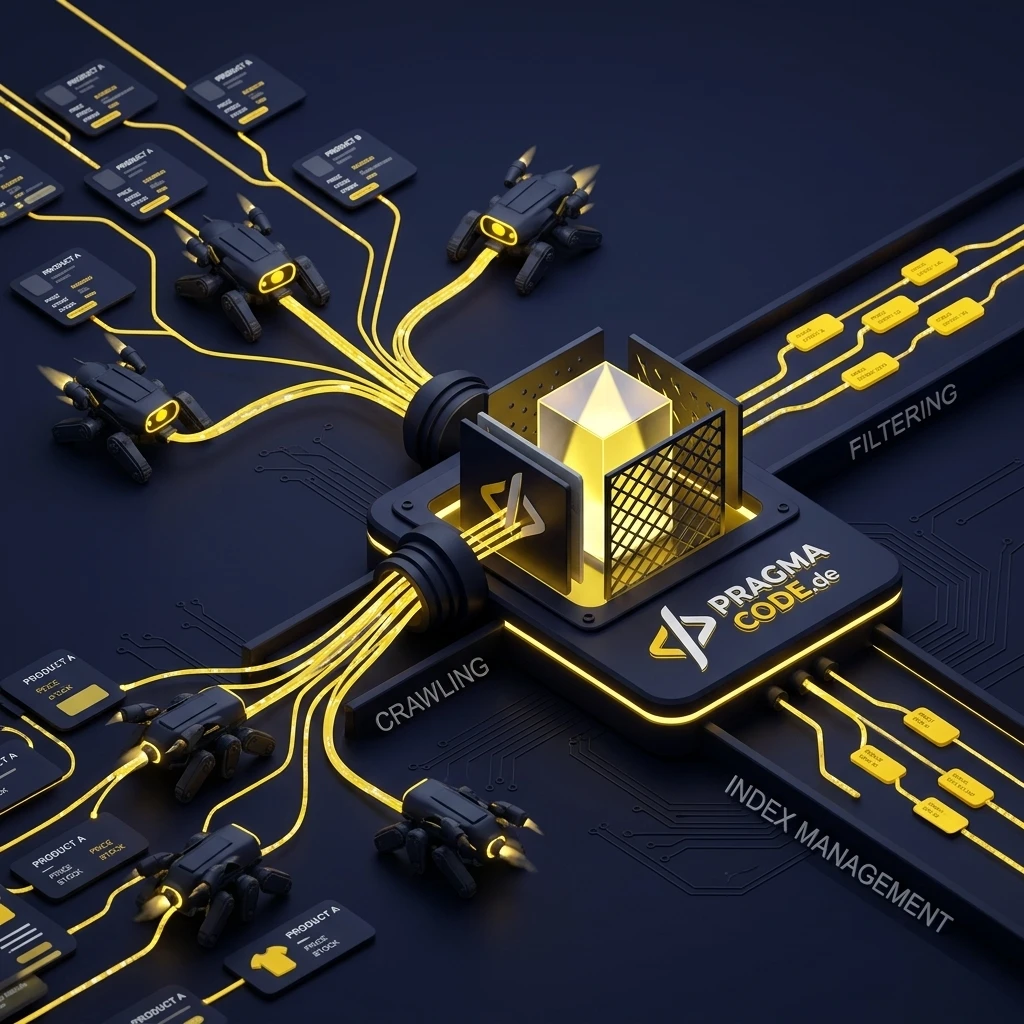
Unkontrollierte Filter können durch kombinatorische Explosion sehr große URL-Räume erzeugen. Viele ähnliche Produktlisten binden Crawling-Ressourcen und können die Entdeckung neuer Produkte verzögern. Das beschreibt Google in seiner Dokumentation zur Facettennavigation; eine automatische De-Indexierung bestehender Produkte folgt daraus nicht.
Um dieses Dilemma nachhaltig zu lösen, bedarf es einer klaren Trennung von Anforderungen an die Benutzeroberfläche und die Indexierungsarchitektur. Moderne Enterprise-Systeme stützen sich dabei auf vier tragende Säulen:
1. Clean Slugs für Suchvolumen
Suchrelevante Filter-Kombinationen (z. B. Kategorie + Marke oder Hauptfarbe) werden als echte, lesbare Clean URLs mit eigenständigem Content, strukturierter H1 und Canonical-Self-Referenz gerendert.
2. Bot-Governance & Scraper-Schutz
Flüchtige und kombinatorische Filter werden anhand ihres Suchnutzens getrennt gesteuert; freigegebene Suchziele bleiben erreichbar.
3. Kanonisierungs-Logik
Ein striktes Regelwerk aus Canonical Tags und serverseitigen Parameternormierungen verhindert, dass identische Produktlisten unter variierender Parameterreihenfolge dupliziert werden.
4. Virtual PRG & Client State
Einsatz moderner Web-Standards wie dem Post-Redirect-Get-Pattern (PRG) oder Client-Side History API Manipulation, um Filterklicks ohne suchmaschinenrelevante Anchor-Links auszuführen.
2. Das Kernproblem: Crawl-Budget-Verschwendung & Duplicate Content
Was ist das Crawl-Budget und warum ist es limitiert?
Das Crawl Budget beschreibt das Gesamtvolumen an URLs, das ein Suchmaschinen-Crawler (wie der Googlebot, Bingbot oder Applebot) innerhalb eines definierten Zeitfensters auf Ihrer Domain abrufen kann und will. Dieses Budget ist keine statische Zahl, sondern das dynamische Ergebnis zweier Kernfaktoren:
Wenn ein Shop nun durch dynamische Filter millionenfache Parameter-URL-Kombinationen generiert (beispielsweise ?color=blue&size=44&price_min=50&sort=rating_desc), verschwendet der Bot seine wertvolle Rechenzeit darauf, marginal veränderte Produktlisten zu parsen. Das Crawl-Budget ist erschöpft, bevor der Crawler die wirklich umsatzrelevanten Produkt-Detailseiten oder neue Kategoriestrukturen erreicht hat.
Spider Traps und die kombinatorische Explosion
Eine sogenannte Spider Trap (Crawler-Falle) entsteht, wenn dynamische Skripte oder Filtermechanismen eine theoretisch unendliche Kette neuer URLs generieren, denen ein Web-Crawler blind folgt. Klassische Auslöser im E-Commerce sind:
- Variierende Parameter-Reihenfolgen:
/schuhe?farbe=rot&groesse=42vs./schuhe?groesse=42&farbe=rot(zwei identische Seiten unter verschiedenen URLs). - Mehrfachauswahlen innerhalb einer Dimension:
/schuhe?farbe=rot,blau,gruen,gelb,schwarz. - Kombination von Filtern mit Sortierungen & Paginierung:
/kategorie?sort=preis_asc&page=7&limit=48&view=grid. - Session-IDs und Tracking-Parameter in internen Links.
Die versteckte Kostenfalle: KI-Scraper & Server-Überlastung
Unnötige Filterabrufe belasten Webserver und Datenbank. Prüfen Sie die tatsächlichen Abrufe und Antwortzeiten in Ihren Logs, bevor Sie Crawl-Regeln oder Zugriffslimits festlegen.
Das Problem: unkontrollierte Filter-URLs
Ein Shop ohne technisches SEO für Filter generiert exponentiell URLs.
Crawling ohne klaren SuchnutzenWiederholte Abrufe ähnlicher Parameter-URLs binden Ressourcen, die für nützliche Produktseiten fehlen können.
Der Idealfall: Clean Index
Ein Shop mit striktem Index-Management und PRG-Pattern.
Gezielt freigegebene URLsPriorisieren Sie nützliche Kategorien, ausgewählte Filter-Landingpages und Produkte; prüfen Sie deren Entdeckung und Indexierung in der Search Console.
3. Technische Lösungen für das Filter-Management
Um die Herausforderungen der Faceted Navigation in den Griff zu bekommen, existieren in der modernen Webentwicklung mehrere etablierte Hebel. Kein einzelnes Werkzeug ist für jeden Anwendungsfall die Universallösung – der Erfolg liegt vielmehr in der orchestrierten Kombination.
Vergleich: Technische Steuerungsmechanismen für Facetten
- Rel="canonical": Signalisiert die bevorzugte URL für gleiche oder sehr ähnliche Inhalte. Kann Crawling langfristig reduzieren, ist aber keine Crawl-Sperre.
- Meta Robots "noindex, follow": Schließt eine Seite aus dem Index aus, wenn Google das Signal crawlen kann. Wichtige Produkte zusätzlich über indexierbare Kategorien verlinken.
- Robots.txt Disallow: Unterbindet Crawling durch Googlebot, garantiert aber keinen Indexausschluss. Produkte müssen über erlaubte Seiten erreichbar bleiben.
- PRG-Pattern (Post-Redirect-Get): Formularbasierte Filterung ohne normalen Anchor-Link; die resultierende GET-URL bleibt separat zu steuern.
- Virtual PRG (Client State): Filterung über JavaScript-State und
<button>-Elemente ohne anklickbarehref-Pfade. - Edge Canonicalization: Cloudflare Workers oder Varnish bereinigen Parameterketten direkt am CDN-Edge vor dem Server-Hit.
Wann nutzt man Canonical vs. Noindex vs. Disallow?
Die Wahl der richtigen Direktive richtet sich nach dem kommerziellen und suchmaschinentechnischen Wert der jeweiligen Filterkombination:
Filterkombinationen mit echtem Marktbedarf (z. B. „Laufschuhe Damen Wasserdicht“ oder „Sneaker Weiß Nike“) werden in indexierbare Clean URLs überführt. Sie erhalten ein selbst-referenzierendes Canonical Tag, optimierte Meta-Daten und eine eigene H1-Überschrift. Welche Facetten diesen Bedarf tatsächlich haben, klärt eine Keyword-Analyse für Online-Shops vor dem Umbau.
Sortierungen und beliebige Kombinationen ohne eigenen Suchnutzen sollen keine eigenständigen Suchziele werden. Paginierte Kategorien sind davon zu trennen: Google empfiehlt eigene URLs und Self-Canonicals für Folgeseiten, damit weitere Produkte erreichbar bleiben.
Begrenzen Sie unnötige Filtermuster anhand einer Freigabeliste. Die Zahl der gewählten Facetten allein entscheidet nicht über den Suchnutzen. Bereits indexierte URLs müssen ihr noindex-Signal zunächst crawlbar ausliefern können.
Beispiel für Indexausschluss im HTML-Head:
<head>
  <!-- Beispiel auf URL: /katalog/sneaker?farbe=rot&sort=preis_asc -->
  <!-- Indexausschluss: Diese URL muss crawlbar bleiben -->
  <meta name="robots" content="noindex, follow" />
</head>
3.1 SEO Filternavigation: Welche Filterseiten indexieren?
Nutzen Sie die folgende Entscheidungshilfe als Freigabe vor der technischen Umsetzung. Die URL-Muster sind illustrative Beispiele, keine pauschalen Indexierungsregeln.
- Indexierbar freigeben: Hat die Kombination eine belegte Suchintention, ein ausreichend stabiles und passendes Sortiment sowie einen eigenständigen Nutzen gegenüber der Elternkategorie? Dann eine dauerhafte, intern verlinkte URL mit passendem Titel, H1 und Self-Canonical vorsehen.
- Nicht als Suchziel freigeben: Fehlen eigener Nutzen oder Nachfrage, keine neue SEO-Landingpage anlegen. Für bereits indexierte Kombinationen ein crawlbares
noindexeinsetzen; für unnötige Crawl-Räume gezielte robots.txt-Regeln prüfen. - Sonderfälle prüfen: Gleiche oder sehr ähnliche Listen per Canonical konsolidieren. Leere oder unsinnige Kombinationen laut Google-Leitfaden mit
404beantworten; Paginierung eigenständig behandeln.
Googles Facetten-Leitfaden beschreibt Crawl-Steuerung und leere Ergebnisse. noindex muss für Google abrufbar bleiben; Canonical dient der Konsolidierung ähnlicher Inhalte.
| Filter-Typ / Facette | Typisches URL-Muster | Technisches SEO-Setup | Index-Status | Architektur-Begründung |
|---|---|---|---|---|
| Kategorie + Hauptmarke | /laufschuhe/nike |
Bei Freigabe: stabile URL + Self-Canonical | Indexierbar bei Freigabe | Nur bei belegter Nachfrage und passendem Sortiment freigeben. |
| Kategorie + Marke + Farbe | /laufschuhe/nike/schwarz |
Bei Freigabe: stabile URL + Self-Canonical | Indexierbar bei Freigabe | Eigenständige Suchintention prüfen, nicht automatisch jede Farbe indexieren. |
| Sortierung (Preis, Beliebtheit) | ?sort=preis_asc |
Canonical bei gleicher oder sehr ähnlicher Liste | Nicht im Index | Reine Umsortierung identischer Produkte; erzeugt reinen Duplicate Content. |
| Preisspannen & Schieberegler | ?price_min=50&price_max=120 |
Virtual PRG oder noindex, follow |
Nicht im Index | Beliebige Slider-Werte begrenzen; kuratierte Preisziele gesondert prüfen. |
| Größen & Mehrfachauswahl | ?size=42,43,44 |
Für bestehende URLs: crawlbares noindex |
Nicht im Index | Mehrfachauswahl begrenzen; eine gesuchte Einzelgröße kann ein eigenes Suchziel sein. |
| Paginierung (Seite 2+) | ?p=2 oder /seite-2 |
Self-Canonical (kein Verweis auf Seite 1!) | Indexierbar | Produkte auf Folgeseiten müssen für Googlebot erreichbar und crawlbar bleiben. |
| Nicht freigegebene Kombination | ?brand=nike&color=rot&size=42&mat=mesh |
Robots.txt Disallow & Edge-Filter | Gesperrt | Crawl-Sperre nach Prüfung bestehender Indexierung; kein pauschales Dimensionslimit. |
3.2 Faceted Navigation SEO in Shopware 6, Shopify & WooCommerce
Die praktische Umsetzung dieser Matrix unterscheidet sich je nach Shopsystem gravierend:
Shopware 6: Eigenschafts-Mapping & Sales-Channel-Kanonisierung
Shopware 6 bietet out-of-the-box ein starkes Datenmodell, generiert für Filter jedoch standardmäßig Parameter-URLs (?properties=...). Best Practice: Konfigurieren Sie suchstarke Filtereigenschaften als eigenständige dynamische Produktgruppen mit sprechenden SEO-URLs. Unkritische Filter werden über das Plugin-Ökosystem oder Custom Twig-Templates auf Virtual PRG umgestellt, um die automatische Generierung von Parametern im DOM zu verhindern.
WooCommerce: Permalink-Struktur & Vermeidung von Filter-Spam
Standard-WooCommerce generiert bei aktiven Facetten URLs wie /kategorie/?filter_farbe=blau. Ohne Eingriff verlinkt das Widget diese URLs als harte Anchor-Tags. Empfehlung: Nutzen Sie Headless-Architekturen oder AJAX-basierte Filter-Plugins, die Klicks als State-Changes verarbeiten. Kanonisieren Sie nur gleiche oder sehr ähnliche Listen auf die Kategorie; freigegebene Suchziele behalten ihre eigene kanonische URL.
Shopify: Tag-Handling & Canonical-Rewrites in Liquid
Shopifys URL-Struktur für gefilterte Collections (/collections/kategorie/filter-tag) erzeugt oft Duplicate Content, wenn Tags unkontrolliert indexiert werden. Prüfen Sie im Theme die Canonical-Ausgabe anhand der Freigabeliste, statt alle Kombinationen pauschal auf die Basis-Collection zu verweisen.
4. Das PRG-Pattern: Filterinteraktion und URL-Steuerung
Das PRG Pattern (Post-Redirect-Get) trennt Formularübermittlung und Ergebnisabruf. Fehlende Anchor-Links allein sind aber keine Indexsperre: Die entstehende GET-URL kann über andere Links bekannt werden. Google dokumentiert crawlbare Links; die Ziel-URLs brauchen weiterhin eine bewusste Crawl- und Indexsteuerung.
Wie das klassische PRG-Pattern im SEO funktioniert
Anstelle normaler Hyperlinks (<a href="...">), denen Web-Crawler automatisch folgen, werden Filterauswahlen als kleine HTML-Formulare mit der HTTP-Methode POST realisiert:
POST-Request bei Filterklick
Der Filterklick sendet die Auswahl per POST statt über einen normalen <a href>-Link. Damit entfällt dieser direkte Crawl-Link; die spätere Ergebnis-URL bleibt jedoch ein eigener Prüfpunkt.
302 / 303 Redirect vom Server
Der Server verarbeitet die ausgewählten Filterparameter, konstruiert die Ziel-URL und antwortet dem Browser mit einem HTTP Status Code 303 (See Other) oder 302 Redirect auf die Ziel-URL.
GET-Request & Produktanzeige
Der Browser des Kunden folgt dem Redirect und lädt die gefilterte Produktübersicht via normalem GET-Request. Der Nutzer erhält die perfekte Ansicht inklusive teilbarer URL, deren Auffindbarkeit und Indexierbarkeit gesondert gesteuert werden müssen.
Experten-Tipp: Das Virtual PRG-Pattern in Headless & Jamstack-Shops
In modernen Headless-E-Commerce-Frontends (z. B. mit Next.js, Remix oder Astro) wird das PRG-Pattern heute oft elegant über Virtual PRG gelöst: Filteroptionen werden semantisch als <button type="button"> gerendert. Bei Klick wird das Produktgrid asynchron via GraphQL/REST aktualisiert und die URL per window.history.replaceState() angepasst. Da Googlebot Buttons ohne href-Attribut standardmäßig nicht anklickt, entfällt dieser direkte Linkpfad. Eine per History API gesetzte Parameter-URL wird dadurch jedoch nicht automatisch uncrawlbar.
5. Link-Attribute & Dofollow/Nofollow Strategien
Wenn ein vollständiger Architekturumbau auf das PRG-Pattern kurzfristig nicht möglich ist, nutzen viele Entwickler HTML-Linkattribute wie rel="nofollow", um den Crawlerfluss zu steuern.
rel="nofollow"
Der Filter-Blocker
Wird an Filter-Links angehängt, denen Crawler nicht folgen sollen (z. B. Sortierungen oder Mehrfachattribute).
ohne rel-Attribut (Standard)
SEO-Landingpages
Wird ausschließlich für kuratierte Clean URLs verwendet, die gezielt in Google ranken sollen (z. B. „Rote Schuhe“).
Nofollow ist keine Crawl-Sperre: Verwenden Sie für freigegebene Suchziele normale Links ohne nofollow; ein besonderes dofollow-Attribut ist nicht nötig. Google erläutert die Linkattribute. Für die Crawl-Steuerung unnötiger Facetten ist robots.txt gezielter als alleinige Nofollow-Hinweise.
6. Roadmap: Shop-Audit & Implementierung
Wie transformieren Sie ein gewachsenes Shopsystem mit akuten Indexierungsproblemen Schritt für Schritt in eine hochperformante, SEO-sichere E-Commerce-Architektur? Folgen Sie diesem bewährten 4-Phasen-Workflow:
Logfile-Analyse & Bot-Bestandsaufnahme
Analysieren Sie einen repräsentativen Zeitraum Ihrer Webserver-Logs. Prüfen Sie, welche Filtermuster Bots häufig abrufen und ob die Entdeckung wichtiger Produkte verzögert wird. Leiten Sie Prioritäten aus dem konkreten Shop ab, nicht aus einer pauschalen Prozentgrenze.
Potential-Mapping: SEO-Facetten vs. UX-Filter
Führen Sie einen Keyword-Abgleich durch. Welche Filterkombinationen besitzen echtes Suchvolumen (z. B. Marke + Kategorie, Material + Kategorie)? Diese Kombinationen werden als indexierbare Clean URLs definiert. Alle sonstigen Filterkombinationen werden für den Ausschluss markiert.
Technische Implementierung (PRG & Edge Rules)
Stellen Sie die Filterschnittstelle im Frontend auf Virtual PRG oder HTML-Formular-POSTs um. Richten Sie in der robots.txt strikte Disallow-Muster für unkritische Parameterketten ein und hinterlegen Sie saubere Canonical-Tags auf allen dynamischen Ansichten.
Monitoring in Google Search Console
Überwachen Sie im Bericht „Seitenindexierung“ die Entwicklung der Kategorien „Gecrawlt – zurzeit nicht indexiert“ und „Ausgeschlossen durch noindex-Tag“. Die Index-Hygiene muss kontinuierlich steigen, während die Crawl-Frequenz auf echten Produktdetailseiten spürbar zunimmt.
7. Best Practices für die URL-Struktur im E-Commerce
Die URL-Struktur ist das Fundament der Informationsarchitektur Ihres Shops. Vermeiden Sie kryptische Parameterketten und setzen Sie auf eine hierarchisch verständliche Trennung zwischen inhaltlicher Entität und Benutzerzustand:
https://www.shop.de/katalog?category=123&brand=nike&color=red&sort=price_asc
Unleserlich für Nutzer und Bots, riskiert Duplicate Content und Crawl-Budget-Verlust.
https://www.shop.de/schuhe/nike/rot
Indexierbar, semantisch klar, optimiert für spezifische Long-Tail-Suchanfragen.
https://www.shop.de/schuhe/nike/rot?sort=price_asc&size=42
Clean URL für die SEO-Dimension; flüchtige Filter laufen im Virtual PRG oder tragen striktes noindex.
Quick-Check: Ihr Weg zum perfekten Index-Management
Haben Sie Fragen zur Shop-Architektur & SEO?
Kostenlose Erstberatung vereinbaren8. Häufig gestellte Fragen (Glossar)
Was ist Faceted Navigation?
Faceted Navigation (Facettennavigation) ist ein User-Interface-Muster, das es Benutzern ermöglicht, Ergebnisse durch die gleichzeitige Anwendung mehrerer Filter wie Farbe, Größe, Preis oder Marke gezielt einzugrenzen. Es ist essenziell für die E-Commerce UX, birgt jedoch erhebliche SEO-Risiken.
Was ist das Crawl Budget?
Das Crawl Budget bezeichnet das Kontingent an URLs, das ein Suchmaschinen-Bot (wie der Googlebot) auf einer Website in einem bestimmten Zeitraum crawlen kann und will. Es hängt von Crawl-Kapazität und Crawl-Nachfrage ab.
Was ist das Canonical Tag?
Das Canonical Tag (rel="canonical") ist ein Signal im Seitenkopf, das die bevorzugte URL für gleiche oder sehr ähnliche Inhalte angibt. Es erzwingt weder die Auswahl dieser URL noch einen Indexausschluss anderer Varianten.
Was ist das PRG Pattern?
Das Post-Redirect-Get (PRG) Pattern ist ein Architekturmuster. Im SEO wird es genutzt, um Filterauswahlen als POST-Formulare abzusenden, die per 302/303-Redirect auf eine GET-URL leiten. Die resultierenden GET-URLs können dennoch über andere Links entdeckt werden und brauchen eigene Crawl- und Indexregeln.
Was ist eine Spider Trap?
Eine Spider Trap (Crawler-Falle) ist ein struktureller Fehler auf einer Website, der Crawler in eine Endlosschleife dynamisch generierter URLs leitet, was das Crawl-Budget in kürzester Zeit vernichtet.
Was bedeutet User Experience (UX)?
User Experience umfasst alle Aspekte der Wahrnehmung und Reaktion eines Nutzers bei der Interaktion mit einem Online-Shop, einschließlich Filtergeschwindigkeit, intuitiver Bedienbarkeit und Friktionsfreiheit im Kaufprozess.
<div class="glossary-item">
    <h3>Welche Filterseiten sollte SEO Filternavigation indexierbar machen?</h3>
    <p>Geben Sie Filterseiten frei, wenn sie eine belegte Suchintention, ein passendes stabiles Sortiment und eigenen Nutzen gegenüber der Elternkategorie haben. Verwenden Sie eine dauerhafte, intern verlinkte URL mit passenden Metadaten und Self-Canonical. Sortierungen und beliebige Kombinationen ohne diesen Nutzen sind keine eigenständigen Suchziele.</p>
</div>

<div class="glossary-item">
    <h3>Sollte man für Faceted Navigation Canonical Tags oder noindex verwenden?</h3>
    <p><a href="https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls" target="_blank" rel="noopener noreferrer">Canonical</a> konsolidiert gleiche oder sehr ähnliche Inhalte und ist keine Indexsperre. noindex schließt eine Seite aus dem Index aus, wenn Google das Signal abrufen kann. robots.txt steuert dagegen das Crawling; eine dort gesperrte Seite kann ihr noindex nicht ausliefern. Produkte müssen zusätzlich über erlaubte Kategorien erreichbar bleiben.</p>
</div>
Quellen
- Google: Faceted Navigation — Stand: 06.11.2026.
- Google: Canonical — Stand: 06.11.2026.
- Google: noindex — Stand: 06.11.2026.
- Google: Pagination — Stand: 06.11.2026.
- Google: Crawlable Links — Stand: 06.11.2026.
SEO & Content für Ihr Unternehmen?
Ich setze das für kleine und mittlere Unternehmen um: zum vorab vereinbarten Festpreis und direkt mit dem, der es baut. Ablauf, Umfang und Preise stehen auf der Leistungsseite.
Leistung & Preise ansehen Oder kostenloses Erstgespräch anfragen