

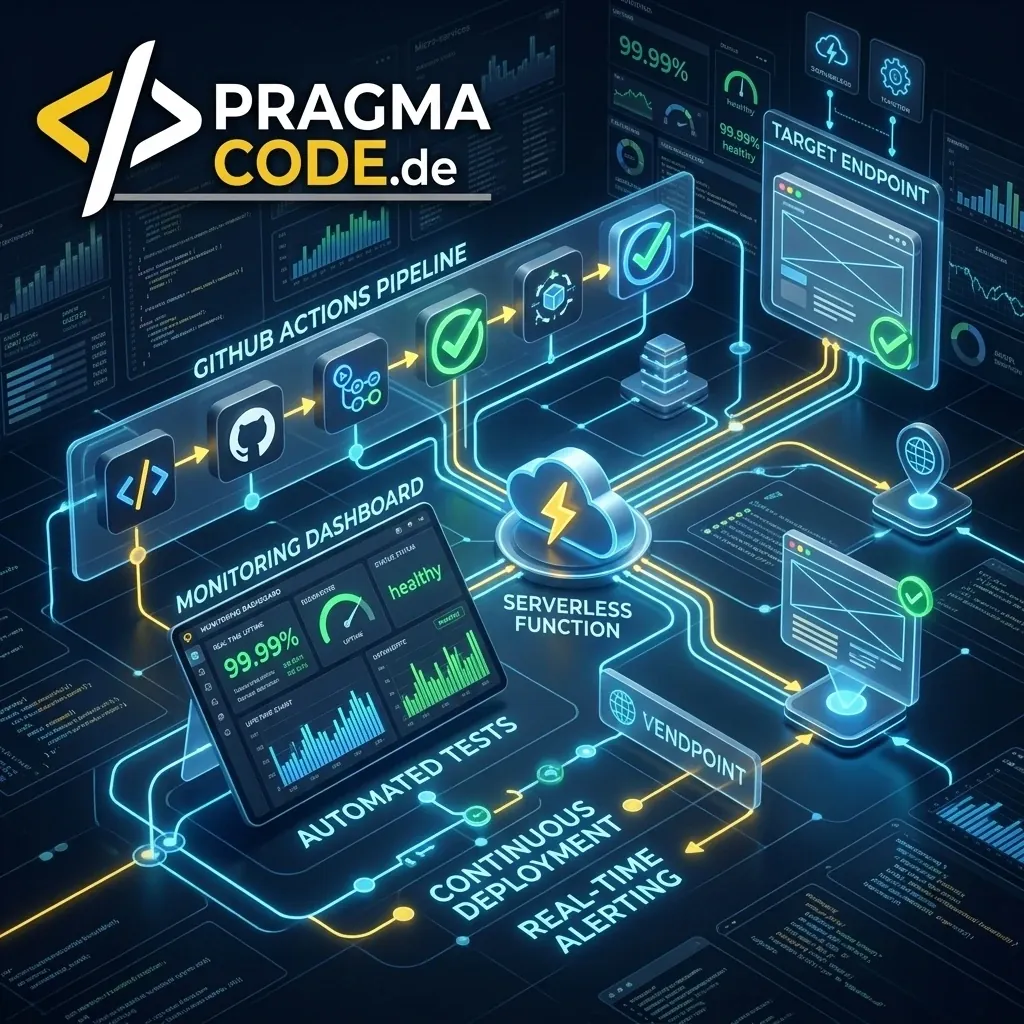
Erfahren Sie, wie Sie starre SaaS-Abonnements eliminieren und mit GitHub Actions sowie Playwright eine hochflexible, serverlose Monitoring-Infrastruktur als Code aufbauen – inklusive End-to-End-Formulartests, Performance-Budgets und KI-Crawlability-Checks.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite:KI-Automatisierung & Web-Workflows →
Die Basis für GEO und autonome KI-Agenten
Im Zeitalter von Agentic AI, Generative Engine Optimization (GEO) und autonomen Web-Agenten ist eine permanente, fehlerfreie Verfügbarkeit Ihrer Web-Präsenz unverzichtbar. Wenn Crawler wie Perplexity, SearchGPT oder Google AI Overviews auf unbemerkte JavaScript-Abstürze, defekte APIs oder blockierte Schemas treffen, wird Ihre Domain unmittelbar aus den Antwort-Indizes gestrichen. Serverloses Synthetic Monitoring schützt Ihre digitale Existenz proaktiv.
- SaaS-Kosten auf 0 € senken: Nutzen Sie die monatlich 2.000 kostenlosen GitHub Actions Runner-Minuten, um Enterprise-Monitoring ohne wiederkehrende Lizenzgebühren zu betreiben.
- Echte funktionale End-to-End-Prüfung: Mit Microsoft Playwright testen Sie nicht nur HTTP-Statuscodes, sondern simulieren reale Nutzerpfade wie mehrstufige Lead-Formulare, Cookie-Banner-Bypasses und Checkout-Trichter im echten Browser.
- Monitoring-as-Code & Multi-Channel-Alerting: Sämtliche Testskripte liegen versioniert im Git-Repository. Bei Fehlern versendet das System innerhalb von Sekunden detaillierte Benachrichtigungen via IONOS SMTP, Slack, Teams oder Telegram inklusive Screenshots und Trace-Dateien.
- 1. Die verborgene Gefahr: Warum HTTP 200 OK trügerisch ist
- 2. Die Kostenfalle traditioneller SaaS-Monitoring-Tools
- 3. Das Prinzip „Monitoring-as-Code“ mit GitHub Actions
- 4. Playwright im Praxiseinsatz: Formulare, Checkouts & Shadow-DOM
- 5. Performance-Budgets & Core Web Vitals (LCP, INP, CLS) in CI
- 6. KI- & Bot-Readiness: Monitoring für SearchGPT, Perplexity & llms.txt
- 7. Vergleich: Traditionelles SaaS vs. Serverloses GitHub Monitoring
- 8. Der Lebenszyklus der Testpipeline: Vom Cron-Trigger zum Alert
- 9. Schritt-für-Schritt: YAML-Workflow & Caching-Optimierung
- 10. Security Governance, Zero-Trust Secrets & OIDC
- 11. Enterprise Best Practices für wartungsfreie Testsuiten
- 12. 5-Stufen-Rollout-Fahrplan zur eigenen Monitoring-Plattform
- 13. Fazit: Datensouveränität & Kostenvorteil durch Code
- 14. Erweitertes Fachglossar
1. Die verborgene Gefahr: Warum HTTP 200 OK trügerisch ist
Viele Unternehmen wiegen sich in falscher Sicherheit: „Unsere Website wurde erst kürzlich modernisiert, der Webserver läuft stabil – warum sollten wir investieren?“ Doch die Realität moderner Web-Architekturen mit Single-Page-Applications (SPAs), komplexen JavaScript-Hydrations, Third-Party-APIs und dynamischen Microfrontends birgt ein enormes Risiko: das sogenannte Silent Failure.
Ein stilles Versagen tritt ein, wenn der Webserver einen einwandfreien HTTP-Statuscode 200 OK zurückgibt, die Benutzeroberfläche im Browser des Nutzers jedoch komplett unbrauchbar ist. Typische Ursachen sind:
Ungefangene JavaScript-Laufzeitfehler
Ein im Hintergrund eingespieltes Update eines Tag-Managers oder Consent-Banners wirft einen Uncaught TypeError und blockiert das gesamte DOM-Rendering.
Veränderte API- & Payload-Strukturen
REST- oder GraphQL-Schnittstellen des CRM- oder Mail-Systems ändern unerwartet ihre Struktur, wodurch der Absende-Button des Kontaktformulars ins Leere läuft.
Fehlerhafte CAPTCHA- & WAF-Blockaden
Anti-Bot-Dienste stufen legitime Nutzeranfragen fälschlicherweise als Bot-Traffic ein, ohne Fehlereinträge im Error-Log des Webservers zu hinterlassen.
Klassische Uptime-Monitore, die lediglich im Fünf-Minuten-Takt einen HTTP-GET-Ping senden, erkennen solche fatalen Funktionsausfälle prinzipbedingt nicht. Erst Wochen später – nach schmerzhaften Einbrüchen bei Inbound-Leads und Umsätzen – bemerkt das Marketing-Team die Störung. Hier setzt modernes Synthetic Monitoring an: Es verlagert die Qualitätsprüfung von der reinen Server-Erreichbarkeit hin zur realen Ausführung sämtlicher Business-Workflows im echten Browser.
2. Die Kostenfalle traditioneller SaaS-Monitoring-Tools
Unternehmen, die professionelles End-to-End-Monitoring etablieren möchten, greifen häufig zu kommerziellen SaaS-Plattformen wie Datadog Synthetics, Pingdom, New Relic oder Dynatrace. Zwar bieten diese Plattformen vorgefertigte Oberflächen, doch sie erweisen sich im geschäftlichen Alltag schnell als massive Kosten- und Flexibilitätsfalle:
Explodierende Lizenzgebühren
Einfache Ping-Checks sind günstig, doch sobald Sie Browser-Synthetics, 1-Minuten-Intervalle oder Multi-Step-Transaktionen für mehrere Domains buchen, steigen die Kosten rasch auf 150 € bis 600 € pro Monat.
Proprietärer Vendor Lock-in
Testlogiken liegen in proprietären No-Code-Editoren der SaaS-Anbieter. Ein Wechsel zu einem anderen Anbieter oder die lokale Ausführung im Entwickler-Workflow erfordert den kompletten Neuaufbau aller Testfälle.
Mangelnde Anpassbarkeit
Spezielle Prüfungen wie das Auslesen von Search-Console-APIs, das Abgleichen von Edge-Worker-Routings oder die Validierung von llms.txt-Dateien lassen sich mit starren SaaS-Tools kaum umsetzen.
3. Das Prinzip „Monitoring-as-Code“ mit GitHub Actions
Die zukunftssichere Alternative zu teuren SaaS-Silos ist das Paradigma Monitoring-as-Code, realisiert über GitHub Actions. GitHub Actions ist die führende Plattform für Continuous Integration (CI/CD) und stellt virtuelle Linux-, Windows- und macOS-Umgebungen direkt im Repository bereit.
Anstatt Testfälle in fremden Dashboards zusammenzuklicken, werden die Überwachungsskripte in Standard-TypeScript oder JavaScript geschrieben und direkt im Git-Repository versioniert. Sie profitieren von denselben Software-Engineering-Standards wie in der Kernanwendung: Pull-Request-Reviews, automatische Linting-Prüfungen, Branching-Strategien und lückenlose Versionshistorie.
GitHub stellt in jedem Standard-Konto 2.000 kostenlose Runner-Minuten pro Monat für private Repositories bereit – in öffentlichen Repositories sind die Ausführungsminuten sogar unbegrenzt. Da ein hochgradig optimierter Playwright-Testlauf in der Regel nur 10 bis 25 Sekunden Rechenzeit benötigt, können Unternehmen Dutzende Webseiten im 15- bis 30-Minuten-Rhythmus völlig kostenlos und hochgradig zuverlässig überwachen.
Uptime & Latenz (TTFB)
Hochfrequente HTTP/3- und cURL-Prüfungen im 5-Minuten-Takt überwachen globale DNS-Auflösung, SSL-Gültigkeit und Time to First Byte zur Erkennung von Serverüberlastungen.
Funktionale E2E-Flows
Echte Browserinstanzen führen mehrstufige Lead-Formulare, Login-Sessions, Suchfilter und Checkout-Abläufe mit dynamischer DOM-Validierung aus.
Core Web Vitals & Speed
Automatisierte Lighthouse-CLI-Audits messen LCP, INP und CLS auf Mobil- und Desktopgeräten und schlagen Alarm, sobald Performance-Budgets verletzt werden.
AI & GEO Bot Readiness
Crawler-Validierung für SearchGPT, Perplexity und Claude: Prüft llms.txt, Schema.org JSON-LD und WAF-Regeln gegen ungewolltes Blocking von KI-Agenten.
4. Playwright im Praxiseinsatz: Formulare, Checkouts & Shadow-DOM
Für die Ausführung der synthetischen Nutzertests setzen wir auf Playwright. Das von Microsoft entwickelte Open-Source-Framework hat sich als De-facto-Standard für modernes E2E-Testing etabliert. Playwright steuert echte Headless Browser (Chromium, Firefox und WebKit für iOS/Safari-Simulation) mit nativer Unterstützung für moderne Web-Standards.
Im Vergleich zu älteren Werkzeugen wie Selenium oder Puppeteer glänzt Playwright durch Auto-Waiting: Es wartet automatisch, bis Elemente im DOM sichtbar, interaktionsfähig und nicht von Animationen überlagert sind. Flaky Tests (unzuverlässige Testabbrüche durch minimale Netzwerkverzögerungen) gehören damit der Vergangenheit an.
Experten-Tipp: Anti-Spam-Filterung bei E2E-Formulartests
Verwenden Sie bei automatisierten Test-Einsendungen stets ein dediziertes Adressmuster wie synthetic-test+monitoring@ihredomain.de und übergeben Sie ein verstecktes Flag oder einen Test-Header. Richten Sie in Ihrem CRM oder Mailserver (z. B. Postfix oder Exchange) eine automatische Lösch- bzw. Archivierungsregel für diese Mails ein, um das operative Vertriebspostfach sauber zu halten.
Das folgende TypeScript-Beispiel demonstriert einen robusten Playwright-Testlauf, der Cookie-Banner auflöst, ein Kontaktformular absendet und im Fehlerfall automatisch einen Vollbild-Screenshot sowie DOM-Snapshots sichert:
import { test, expect } from '@playwright/test';

test.describe('Synthetisches Website-Monitoring', () => {
  test('Kontaktformular absenden & Funktionalität validieren', async ({ page }) => {
    // 1. Navigation mit Netzwerk-Idle-State
    const response = await page.goto('https://www.pragma-code.de/kontakt', {
      waitUntil: 'domcontentloaded',
      timeout: 15000,
    });

    // Statuscode validieren
    expect(response?.status()).toBe(200);

    // 2. Cookie-Banner defensiv abfangen (falls aktiv)
    const cookieAcceptBtn = page.getByRole('button', { name: /alle akzeptieren|einverstanden/i });
    if (await cookieAcceptBtn.isVisible({ timeout: 2000 })) {
      await cookieAcceptBtn.click();
    }

    // 3. Formularfelder über barrierefreie Rollen & Labels ansteuern
    await page.getByLabel(/Name/i).fill('Synthetic Monitoring Agent');
    await page.getByLabel(/E-Mail/i).fill('synthetic-test+monitoring@pragma-code.de');
    await page.getByLabel(/Nachricht/i).fill('Automatisierter Systemtest zur Qualitätssicherung.');

    // 4. Formular absenden
    const submitBtn = page.getByRole('button', { name: /anfrage absenden|nachricht senden/i });
    await expect(submitBtn).toBeEnabled();
    await submitBtn.click();

    // 5. Erfolgsstatus verifizieren (Dankeseite oder Toast-Message)
    const successToast = page.locator('.form-success-message, [data-testid="success-toast"]');
    await expect(successToast).toBeVisible({ timeout: 8000 });
  });
});
5. Performance-Budgets & Core Web Vitals (LCP, INP, CLS) in CI
Die Ladezeit und Responsivität einer Webseite entscheiden maßgeblich über Conversion-Rates und Suchmaschinen-Platzierungen. Google bewertet Webauftritte nach den Core Web Vitals:
Largest Contentful Paint (LCP)
Misst die Ladezeit des größten sichtbaren Inhaltselements (Haupt-Hero oder Bild). Zielwert: < 2,5 Sekunden.
Interaction to Next Paint (INP)
Misst die Reaktionsverzögerung der Benutzeroberfläche auf Klicks oder Tastatureingaben. Zielwert: < 200 Millisekunden.
Cumulative Layout Shift (CLS)
Misst unerwartete visuelle Layout-Verschiebungen während des Renderns von Elementen. Zielwert: < 0,1.
Häufig führen nachträglich eingebaute Tracking-Skripte, Werbebanner oder unkomprimierte Medien zu schleichenden Performance-Verlusten (Performance Regression). Durch die Integration der Lighthouse CLI in den nächtlichen GitHub Actions Workflow können Sie feste Performance-Budgets definieren.
Sobald ein Inhalts- oder Code-Update den LCP über 2,5 Sekunden treibt oder der Performance-Score unter 95 fällt, schlägt die Pipeline fehl und alarmiert das Entwicklerteam sofort – noch bevor Google die Ranking-Signale abwertet.
6. KI- & Bot-Readiness: Monitoring für SearchGPT, Perplexity & llms.txt
Im Jahr 2026 vollzieht sich im Suchmaschinenmarkt ein fundamentaler Wandel: Neben dem klassischen Google-Crawler scannen autonome KI-Agenten, SearchGPT, Perplexity Sonar und Claude Search das Web in Echtzeit, um Antworten direkt zu synthetisieren.
Damit Ihre Inhalte von diesen Agenten zitiert werden, muss Ihre Website für KI-Bots optimiert und permanent fehlerfrei crawlbar sein (Agentic Browsing & GEO). Ein modernes GitHub Actions Monitoring prüft daher gezielt:
Verfügbarkeit der /llms.txt & /llms-full.txt
Validierung, dass maschinenlesbare KI-Dokumentationsdateien mit HTTP 200 OK ausgeliefert werden und keine Syntaxfehler enthalten.
Schema.org JSON-LD Validierung
Prüfung, ob strukturierte Daten (wie Organization, Article, FAQPage oder OfferCatalog) im DOM vorhanden sind und den offiziellen Standards entsprechen.
Cloudflare- & WAF-Regelwerk-Audit
Überprüfung, dass Sicherheits- und Bot-Filter (z. B. Bot Fight Mode) legitime KI-Crawler nicht versehentlich mit 403 Forbidden oder Captcha-Challenges aussperren.
7. Vergleich: Traditionelles SaaS vs. Serverloses GitHub Monitoring
Die Gegenüberstellung zeigt, warum immer mehr technologieorientierte Unternehmen und Digitalagenturen von proprietären SaaS-Monitoren auf Git-basierte Pipelines umsteigen:
Vergleich: SaaS-Tool vs. GitHub Serverless Monitoring
- Kostenstruktur: Hohe monatliche Abogebühren (150 € – 600 € / Monat bei Multi-Domain Synthetics).
- Flexibilität: Starr vorgegebene Check-Routinen; individuelle API-Aufrufe oft limitiert.
- Datenschutz & DSGVO: Datenverarbeitung auf US-Servern erfordert aufwendige AVVs und birgt Rechtsrisiken.
- Versionskontrolle: Konfigurationen liegen isoliert im Web-Dashboard, getrennt vom Quellcode.
- Alerting: Starre E-Mail-Templates; SMS- und Webhook-Alerts häufig aufpreispflichtig.
- Kostenstruktur: 0 € laufende Kosten durch 2.000 kostenlose GitHub Runner-Minuten pro Monat.
- Flexibilität: Grenzenlose Anpassbarkeit durch volle TypeScript-, Node.js- und Python-Unterstützung.
- Datenschutz & DSGVO: Volle Datensouveränität; direkte Anbindung an europäische SMTP-Server (z. B. IONOS).
- Versionskontrolle: „Monitoring-as-Code“ – alle Prüfskripte liegen versioniert im Git-Repository.
- Alerting: Native Multi-Channel-Anbindung an Slack, Teams, Discord, Telegram & E-Mail.
8. Der Lebenszyklus der Testpipeline: Vom Cron-Trigger zum Alert
Da beim serverlosen Monitoring keine dauerhaften Server betrieben werden müssen, wird die gesamte Testumgebung bei jedem Durchlauf auf Abruf bereitgestellt und nach Abschluss rückstandslos bereinigt:
Der GitHub Actions Scheduler startet den Workflow automatisch nach dem im YAML definierten Zeitplan (z. B. alle 15 Minuten für Uptime oder täglich um 02:00 Uhr für Deep E2E).
GitHub startet einen isolierten Ubuntu-Container. Node.js wird eingerichtet und die Playwright-Browser-Binaries werden blitzschnell aus dem GitHub Cache geladen.
Playwright navigiert die Zielseiten an, validiert HTTP-Status, füllt Formulare aus und prüft DOM-Elemente. Parallel werden Netzwerk-Timeouts und Fehlermeldungen protokolliert.
Schlägt eine Assertion fehl, erstellt Playwright automatisch Vollbild-Screenshots, Videoaufnahmen des Durchlaufs und einen vollständigen Trace-Datensatz.
Der Schritt if: failure() wird ausgelöst: Ein formatierter Fehlerbericht mit Screenshot wird per IONOS SMTP an die Administratoren und per Webhook in den Slack-Alerting-Kanal gesendet.
9. Schritt-für-Schritt: YAML-Workflow & Caching-Optimierung
Die zentrale Orchestrierung erfolgt über eine deklarative Workflow-Datei im Verzeichnis .github/workflows/website-synthetic-monitoring.yml.
Experten-Tipp: Browser-Caching halbiert die Laufzeit
Durch den Einsatz von actions/cache für den Playwright-Browserordner (~/.cache/ms-playwright) entfällt das zeitraubende Herunterladen der Browser-Binaries bei jedem Workflow-Lauf. Dies senkt die Ausführungszeit von ~45 Sekunden auf unter 12 Sekunden und spart bis zu 70 % Ihrer Freiminuten ein.
Hier ist die vollständige, produktionsreife Konfiguration inklusive Caching, Secrets-Übergabe und automatischem Artefakt-Upload:
name: Synthetic Website Monitoring

on:
  schedule:
    # Ausführung alle 30 Minuten (UTC)
    - cron: '*/30 * * * *'
  workflow_dispatch: # Ermöglicht manuellen Start im GitHub-Dashboard

jobs:
  run-synthetic-monitor:
    name: E2E Playwright & Uptime Audit
    runs-on: ubuntu-latest
    timeout-minutes: 5

    steps:
      - name: 📥 Quellcode auschecken
        uses: actions/checkout@v4

      - name: ⚙️ Node.js 20 einrichten
        uses: actions/setup-node@v4
        with:
          node-version: 20
          cache: 'npm'

      - name: 📦 Dependencies installieren
        run: npm ci

      - name: ⚡ Playwright Browser Cache abrufen
        id: playwright-cache
        uses: actions/cache@v4
        with:
          path: ~/.cache/ms-playwright
          key: ${{ runner.os }}-playwright-${{ hashFiles('**/package-lock.json') }}

      - name: 🌐 Playwright Chromium installieren (falls nicht im Cache)
        if: steps.playwright-cache.outputs.cache-hit != 'true'
        run: npx playwright install --with-deps chromium

      - name: 🚀 Synthetische Monitoring-Tests ausführen
        env:
          TARGET_URL: ${{ secrets.MONITORING_TARGET_URL }}
          ALERT_SMTP_HOST: ${{ secrets.ALERT_SMTP_HOST }}
          ALERT_SMTP_USER: ${{ secrets.ALERT_SMTP_USER }}
          ALERT_SMTP_PASS: ${{ secrets.ALERT_SMTP_PASS }}
          SLACK_WEBHOOK_URL: ${{ secrets.SLACK_WEBHOOK_URL }}
        run: npx playwright test tests/monitoring/ --reporter=list

      - name: 📸 Screenshots & Traces bei Fehler hochladen
        if: failure()
        uses: actions/upload-artifact@v4
        with:
          name: failure-evidence-reports
          path: |
            test-results/
            playwright-report/
          retention-days: 7
10. Security Governance, Zero-Trust Secrets & OIDC
Da Monitoring-Skripte sensible Aktionen auf Produktionssystemen ausführen und Zugriff auf Kommunikationskanäle benötigen, muss die Sicherheitsarchitektur strengen Governance-Standards genügen:
Encrypted Repository Secrets
Passwörter, Webhooks und API-Tokens werden ausschließlich verschlüsselt in GitHub Secrets hinterlegt und niemals im Klartext im Repository abgelegt.
OIDC (OpenID Connect) Token-Austausch
Verzichten Sie auf langlebige Cloud-Zugangsdaten: Nutzen Sie GitHub OIDC, um kurzlebige, signierte Authentifizierungs-Tokens für Cloudflare oder AWS zu generieren.
Isolierte Container-Sandboxes
Jeder Testlauf startet in einer frischen, flüchtigen virtuellen Maschine ohne persistente Datenhaltung. Nach Durchlaufende werden alle temporären Daten vernichtet.
WAF & Rate-Limiting Whitelisting
Konfigurieren Sie Ihre Firewall so, dass dedizierte Test-Header (z. B. X-Pragma-Synthetic-Token) erkannt werden, um unbeabsichtigte IP-Sperren zu verhindern.
11. Enterprise Best Practices für wartungsfreie Testsuiten
Um sicherzustellen, dass Ihre Monitoring-Pipeline verlässlich arbeitet und keine frustrierenden Fehlalarme (False Positives) erzeugt, sollten Sie fünf bewährte Architekturregeln befolgen:
1. Robuste Selektoren via Accessible Roles
Vermeiden Sie fragile CSS-Klassen wie .btn-primary-v2. Nutzen Sie stattdessen barrierefreie Selektoren wie page.getByRole('button', { name: 'Absenden' }) oder dedizierte Test-IDs (data-testid). So überstehen Ihre Tests jedes Design-Update.
2. Dynamische Timeouts & Retry-Strategien
Setzen Sie kurze Netzwerk-Timeouts (5–10 Sekunden) für Uptime-Checks und konfigurieren Sie Playwright mit retries: 1 im CI-Modus. Ein einmaliger Paketverlust löst so keinen sofortigen Alarm aus – erst ein wiederholter Fehler alarmiert das Team.
3. Trace-Viewer & Videoaufzeichnungen
Aktivieren Sie Playwrights Trace-Aufzeichnung bei Fehlern (trace: 'retain-on-failure'). Über das Online-Tool trace.playwright.dev können Sie den Testschritt wie ein Video Bild für Bild inklusive Netzwerk-Wasserfall nachvollziehen.
4. Git-basiertes Performance-Logbuch
Lassen Sie Ladezeit- und Performance-Messergebnisse am Ende des Workflows als komprimierte JSON-Dateien in ein separates Metrics-Repository committen. So erhalten Sie ein lückenloses, kostenloses Performance-Logbuch über Jahre hinweg.
5. Multi-Channel-Alerting mit IONOS SMTP & Webhooks
Senden Sie Vorfälle nicht nur als E-Mail, sondern leiten Sie formatierte Markdown-Nachrichten direkt in Ihren zentralen Incident-Kanal in Slack, Discord oder MS Teams weiter – inklusive Direktlink zum Fehlerscreenshot im GitHub Run.
12. 5-Stufen-Rollout-Fahrplan zur eigenen Monitoring-Plattform
Die Einführung einer serverlosen Synthetic-Monitoring-Infrastruktur lässt sich in fünf klar definierten Phasen strukturiert umsetzen:
-
Phase 1: Inventur der geschäftskritischen User Journeys
Identifizieren Sie die conversion-kritischsten Pfade Ihrer Website: Lead-Formulare, Newsletter-Anmeldungen, Login-Prozesse, Suchfilter und Checkout-Trichter.
-
Phase 2: Playwright-Testsuite lokal entwickeln & härten
Schreiben Sie modulare TypeScript-Testskripte mit robusten Role-Selektoren, Cookie-Bypasses und klaren Erfolgs-Assertions. Testen Sie die Skripte lokal im Headless-Modus.
-
Phase 3: GitHub Actions YAML-Pipeline & Caching aufsetzen
Erstellen Sie die Workflow-Definition unter
.github/workflows/, binden Sie Cron-Schedules ein und konfigurieren Sie das Caching für die Browser-Binaries. -
Phase 4: Secrets hinterlegen & Alerting-Kanäle anbinden
Hinterlegen Sie SMTP-Zugangsdaten und Webhook-URLs in den GitHub Repository Secrets und testen Sie das Alerting durch gezieltes Provozieren eines Testfehlers.
-
Phase 5: Performance-Budgets & AI-Readiness integrieren
Erweitern Sie die Pipeline um Lighthouse Core Web Vitals Audits und Validierungs-Checks für
llms.txtund Schema.org-Strukturen.
13. Fazit: Datensouveränität & Kostenvorteil durch Code
Serverloses Website-Monitoring mit GitHub Actions und Playwright ist der modernste und wirtschaftlichste Weg, digitale Web-Präsenzen abzusichern. Durch das Paradigma „Monitoring-as-Code“ gewinnen Sie maximale Kontrolle über Ihre Testlogiken, verhindern fatale Silent Failures und eliminieren wiederkehrende SaaS-Abonnements vollständig.
Für Unternehmen und Agenturen bietet dieser Ansatz einen unschlagbaren Hebel: Sie steigern die technische Zuverlässigkeit Ihrer Plattformen auf Enterprise-Niveau und sichern gleichzeitig Ihre Sichtbarkeit bei klassischen Suchmaschinen und modernen KI-Such-Agenten.
Quick-Check: Ihr Einstieg ins serverlose Monitoring
Möchten Sie Ihr Website-Monitoring auf GitHub Actions umstellen?
Kostenlose Erstberatung vereinbarenHaben Sie eine Vision?
Lassen Sie uns gemeinsam prüfen, wie wir Ihre Idee zum Fliegen bringen.
Jetzt kostenloses Strategiegespräch buchenErweitertes Fachglossar
GitHub Actions
Ein CI/CD- und Automatisierungs-Tool von GitHub, das es ermöglicht, direkt im Repository Workflows für Builds, Tests und serverloses Website-Monitoring auszuführen.
Playwright
Ein modernes Open-Source-Framework von Microsoft für automatisiertes E2E-Testing in Browsern wie Chromium, Firefox und WebKit, das für robustes Website-Monitoring genutzt wird.
E2E-Testing
End-to-End-Testing ist eine Testmethode, bei der der gesamte Ablauf einer Anwendung (z.B. User-Login oder Formularversand) aus Sicht des Endbenutzers im echten Browser geprüft wird.
Headless Browser
Ein Webbrowser (wie Chrome oder Firefox) ohne grafische Benutzeroberfläche. Er wird über Skripte gesteuert und eignet sich perfekt für automatisierte Tests und Website-Monitoring in der Cloud.
Synthetic Monitoring
Eine automatisierte Überwachungsmethode, bei der Skripte menschliche Interaktionen und API-Aufrufe in regelmäßigen Intervallen simulieren, um Verfügbarkeit, Latenz und Funktionalität proaktiv zu prüfen.
Continuous Integration (CI/CD)
Eine DevOps-Praxis, bei der Code-Änderungen automatisch gebaut, getestet und bereitgestellt werden, um Softwarefehler frühzeitig zu identifizieren und Ausfallzeiten zu minimieren.
Performance Budget
Ein vordefiniertes Limit für technische Leistungskennzahlen wie Ladezeiten, JavaScript-Dateigrößen oder Core Web Vitals (LCP, INP, CLS), dessen Überschreitung in CI/CD Builds fehlschlagen lässt.
Core Web Vitals
Ein Set von drei Metriken (LCP, INP, CLS), mit denen Google die User Experience einer Webseite misst und bewertet.
