

Autonome KI-Agenten und Multi-Agenten-Systeme transformieren die Softwareentwicklung von manueller Code-Produktion zur übergeordneten System-Orchestrierung. Erfahren Sie, wie moderne Engineering-Teams mit Cursor, Claude Code, Cline und MCP skalieren und warum automatisierte Verifikation den entscheidenden Unterschied macht.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite:KI-Automatisierung für Unternehmen →
- Paradigmenwechsel zur Autonomie: Der Übergang von einfachen Autocomplete-Copilots hin zu zielorientierten, autonomen Multi-Agenten-Systemen markiert den größten Produktivitätssprung in der Geschichte des Software-Engineerings.
- Die drei Kern-Archetypen & MCP: Moderne Entwicklungswerkzeuge unterteilen sich in IDE-integrierte Systeme (Cursor, Windsurf), terminalbasierte Kommandozeilen-Agenten (Claude Code, Cline) und autonome Cloud-Ingenieure (Devin) – standardisiert verknüpft über das Model Context Protocol (MCP).
- Die Verifikations-Herausforderung: Weil Agenten das Codevolumen exponentiell vergrößern, verschiebt sich der Engpass von der Code-Erstellung hin zur Verifikation. Spec-Driven Engineering, automatisierte Test-Suites und Human-in-the-Loop-Gates sind zwingend erforderlich, um Software-Fäulnis zu verhindern.
Die neue Ära der Software-Autonomie
Im Jahr 2026 schreiben Software-Ingenieure Code nicht mehr isoliert Zeile für Zeile. Wir orchestrieren Agenten-Schwärme, die ganze Feature-Zweige eigenständig entwerfen, refaktorieren, testen und zur Produktionsreife bringen. Wer diesen Wandel meistert, skaliert seine Entwicklungskapazitäten ohne linearen Headcount-Zuwachs.
- 1. Einleitung: Der Schritt von Assistenz zu Autonomie
- 2. Vergleich: Copilots vs. Multi-Agenten-Systeme
- 3. Die drei Archetypen moderner AI Coding Assistants
- 4. Architektur: Das Zusammenspiel im Agenten-Schwarm
- 5. Die unsichtbare Triade: Context, Tools & Reasoning
- 6. Die 4 Architektur-Schichten im Detail
- 7. Interaktiver Benchmark: Frontier-Modelle im Coding-Test
- 8. Spec-Driven Engineering vs. „Vibe Coding“
- 9. Die „Shipping-Lücke“: Warum mehr Code nicht mehr Produktivität bedeutet
- 10. Risiken & Fallstricke im Unternehmenseinsatz
- 11. Roadmap: Implementierung im Software-Team
- 12. Quick-Check vor dem Fazit
- 13. Fazit & Ausblick: Der Entwickler als System-Orchestrator
1. Einleitung: Der Schritt von Assistenz zu Autonomie
Seit dem Durchbruch der Generativen KI hat sich die Softwareentwicklung rasant gewandelt. Zu Beginn etablierten sich einfache Autocomplete-Assistenten (wie die erste Generation von GitHub Copilot) als digitale Helfer. Diese Werkzeuge funktionierten im Wesentlichen wie eine hoch entwickelte Autokorrektur: Sie schlugen die nächste Zeile Code oder eine isolierte Hilfsfunktion vor, basierend auf dem unmittelbaren Kontext der geöffneten Datei. Sie agierten rein reaktiv – sie warteten auf Tastatureingaben des Programmierers, um kleinteilig zu unterstützen.
Im Jahr 2026 befinden wir uns in einer völlig neuen Realität: der Ära hochgradig vernetzter Multi-Agenten-Systeme. Der fundamentale Unterschied liegt im Schritt von passiver Assistenz zu echter operativer Autonomie. Entwickler übergeben einer KI heute keine Code-Fragmente mehr zur Vervollständigung. Stattdessen formulieren sie vollständige, funktionale Epics und User Stories: „Erstelle eine neue API-Schnittstelle zur Synchronisation von Bestandsdaten aus unserem ERP-System, binde sie an das Model Context Protocol an, schreibe dafür lückenlose Unit- und Integrationstests und stelle sicher, dass alle Core Web Vitals und Sicherheits-Gates eingehalten werden.“
Ein moderner AI Coding Assistant nimmt dieses Ziel entgegen, analysiert die gesamte Codebasis, entwirft einen mehrstufigen Implementierungsplan, führt Änderungen synchron über Dutzende von Quelldateien durch, führt Tests im Terminal aus, korrigiert Typfehler eigenständig und präsentiert dem menschlichen Entwickler am Ende einen fertigen, verifizierten Pull-Request. Diese Entwicklung verändert die Rolle des Software-Ingenieurs grundlegend: vom reinen Code-Autor zum strategischen System-Architekten, Reviewer und Orchestrator.
Besonders für mittelständische Unternehmen im DACH-Raum bietet diese Technologie die historische Chance, dem anhaltenden Fachkräftemangel in der IT aktiv zu begegnen. Statt Entwicklerteams linear vergrößern zu müssen, können bestehende Teams ihre Hebelwirkung (Leverage) durch den gezielten Einsatz autonomer Agenten vervielfachen. Doch dieser Wandel gelingt nur, wenn Unternehmen die architektonischen Grundlagen, die Werkzeugklassen und die damit verbundenen Risiken präzise verstehen.
2. Vergleich: Copilots vs. Multi-Agenten-Systeme
Um die Tragweite dieses Technologiewandels zu verstehen, müssen wir klassische Assistenz-KIs (Copilots) direkt mit modernen Multi-Agenten-Systemen vergleichen. Während Copilots im Texteditor verbleiben, agieren Agenten als vollwertige Akteure in der gesamten Entwicklungsumgebung.
Gegenüberstellung: Klassische Copilots vs. Autonome Multi-Agenten-Systeme
- Interaktionsmodell: Reaktiv. Wartet auf Tastatureingaben des Entwicklers oder explizite Prompts für kurze Codeabschnitte.
- Kontext-Reichweite: Lokal. Analysiert meist nur die aktuell geöffnete Datei und direkt angrenzende Imports.
- Aktionsradius: Read-Write im Editor. Kann Code schreiben und modifizieren, hat aber keinen Systemzugriff.
- Fehlerbehandlung: Keine. Wenn der generierte Code Syntaxfehler enthält, muss der Entwickler diese manuell korrigieren.
- Zielorientierung: Zeilen- und Funktionsebene. Keine langfristige Planung oder konzeptionelle Strukturierung möglich.
- Interaktionsmodell: Proaktiv. Erhält ein globales Ziel, plant eigenständig Teilschritte und arbeitet diese im Schwarm ab.
- Kontext-Reichweite: Global & Protokoll-basiert. Indiziert das gesamte Repository, liest PRDs und nutzt das Model Context Protocol.
- Aktionsradius: Voller Systemzugriff. Kann Dateien anlegen, Terminalbefehle ausführen, Sandbox-Tests starten und Browser steuern.
- Fehlerbehandlung: Autonomer Loop. Liest Compiler- und Testfehler im Terminal aus und korrigiert den eigenen Code selbstständig.
- Zielorientierung: Feature- und Ticket-Ebene. Kann komplexe Refactorings, Migrationen und End-to-End-Features umsetzen.
3. Die drei Archetypen moderner AI Coding Assistants
Der Markt für agentische Programmierwerkzeuge hat sich konsolidiert. Heute lassen sich die Tools in drei wesentliche Archetypen unterteilen, die sich in ihrer Systemintegration, ihrem Autonomiegrad und ihrem primären Einsatzzweck unterscheiden. Software-Architekten und CTOs müssen diese Klassen kennen, um die passenden Werkzeuge für ihre Teams auszuwählen.
IDE-Embedded Agents (z. B. Cursor Composer, Windsurf)
Diese Agenten sind direkt in die Entwicklungsumgebung integriert oder bilden selbst eine KI-native Abspaltung etablierter Editoren wie VS Code. Sie sind für die tägliche, interaktive Zusammenarbeit mit dem Programmierer optimiert. Durch die tiefe Integration besitzen sie perfekten Zugriff auf den aktuellen Arbeitskontext (offene Tabs, Cursor-Position, Git-Diffs, Terminal-Fehler). Sie glänzen bei schnellen Multi-File-Edits unter direkter Aufsicht des Entwicklers und erlauben parallele Hintergrund-Tasks, während der Programmierer ungestört weiterdenkt.
Terminal-First & CLI Agents (z. B. Claude Code, Cline)
Diese Werkzeuge leben direkt in der Kommandozeile (CLI) oder steuern die Umgebung über ein mächtiges Terminal-Interface. Ihr Fokus liegt auf maximaler Handlungsfreiheit im lokalen System. Werkzeuge wie Anthropics Claude Code nutzen hybride Reasoning-Modelle wie Claude 3.7 Sonnet, um über das Terminal Skripte auszuführen, Datenbank-Migrationen anzustoßen, Docker-Container hochzufahren und lokale Test-Suites zu steuern. Cline bindet zusätzlich MCP-Server ein, bei denen jeder Schreibzugriff transparent bestätigt werden kann.
Autonomous Cloud Engineers (z. B. Devin)
Die Spitze der Autonomie bilden cloudbasierte Agenten. Sie agieren nicht auf dem Entwicklerrechner, sondern in einer isolierten virtuellen Sandbox in der Cloud. Verbunden mit GitHub und Issue-Trackern (Jira, Linear) arbeiten sie über Stunden hinweg eigenständig an komplexen Aufgabenstellungen. Sie verfügen über eigene Webbrowser zur Dokumentationsrecherche, installieren Abhängigkeiten und führen umfangreiche Testreihen aus. Sie fungieren als digitale Teammitglieder, die Tickets in fertige Pull-Requests verwandeln.
4. Architektur: Das Zusammenspiel im Agenten-Schwarm
In professionellen Softwareprojekten arbeitet selten ein einzelner Agent isoliert. Vielmehr entsteht eine koordinierte Pipeline, die von formalen Vorgaben über die Orchestrierung und Implementierung bis hin zur automatisierten Verifikation reicht. Das folgende Erklär-Diagramm visualisiert diesen vierstufigen Prozess:
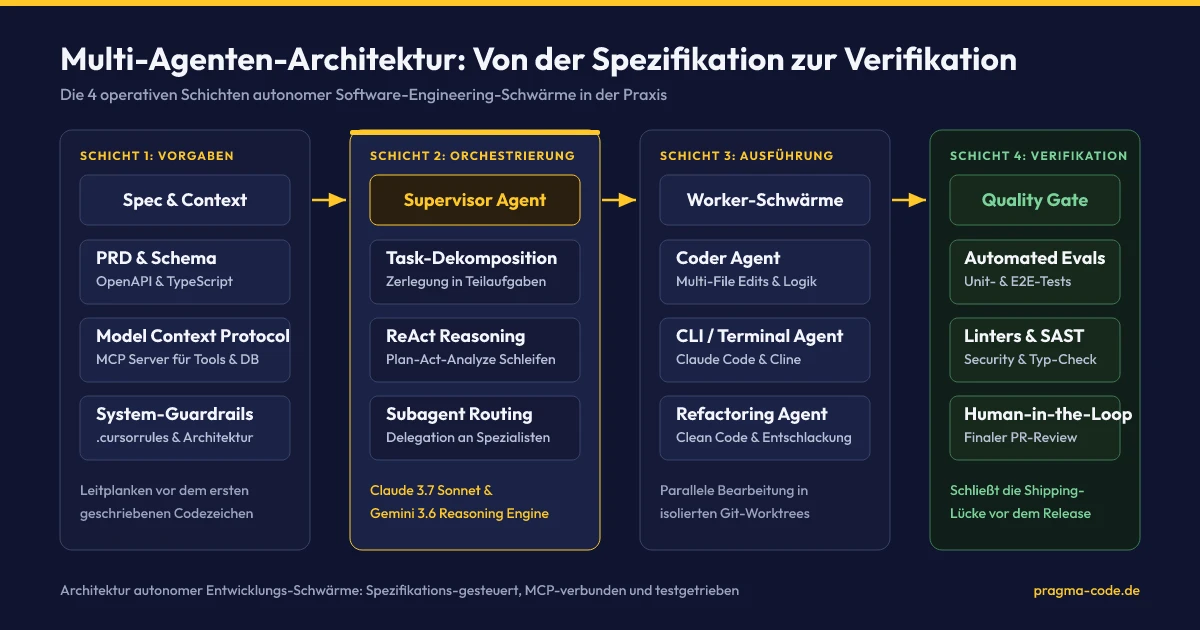
Der entscheidende Vorteil dieser Architektur liegt in der Entkopplung: Kein Agent schreibt unkontrolliert Code in das Haupt-Repository. Jeder Schritt unterliegt klaren Leitplanken, und erst wenn alle automatisierten Tests in einer Sandbox erfolgreich durchlaufen wurden, gelangt der Pull-Request zur finalen Freigabe an einen menschlichen Senior-Entwickler.
5. Die unsichtbare Triade: Context, Tools & Reasoning
Wie schafft es ein autonomer Agent, eine komplexe Codebasis fehlerfrei zu modifizieren, während Menschen oft Tage benötigen, um sich in fremdem Code zurechtzufinden? Die Antwort liegt in der Kombination dreier Säulen, die wir als die agentische Triade bezeichnen:
Context Retrieval & MCP
Bevor ein Agent ein einziges Zeichen schreibt, indiziert er das gesamte Projekt. Über AST-Parser (Abstract Syntax Trees) und Vektordatenbanken baut er ein semantisches Verständnis zwischen Klassen, Funktionen und Datenbank-Schemata auf. Über das Model Context Protocol (MCP) greift er standardisiert auf externe Dokumentationen, APIs und Datenbankstrukturen zu, während Projektdateien wie .cursorrules feste architektonische Leitplanken setzen.
Tool-Enabling & Sandboxing
Ein Sprachmodell allein ist rein passiv. Erst durch Werkzeuge wird es zum operativen Agenten. Der Agent verfügt über Schnittstellen zum Lesen und Schreiben von Dateien, Durchsuchen von Repositories, Ausführen von Shell-Befehlen (z. B. pnpm test) und Starten von Headless-Browsern zur visuellen Prüfung. Sicherheits-Sandboxes verhindern unbefugte Systemzugriffe.
Reasoning Loops & ReAct
Das Herzstück ist die Planungs- und Korrekturschleife nach dem ReAct-Prinzip (Reason-Act-Analyze). Der Agent plant einen Schritt, führt ihn aus, analysiert das Compiler- oder Testergebnis im Terminal und passt seinen Plan dynamisch an. Scheitert ein Lösungsansatz, setzt er den Git-Zustand zurück und probiert eine alternative Route – genau wie ein erfahrener Ingenieur.
Ein konkretes Praxisbeispiel zeigt, wie dieser Reasoning-Prozess bei der Aktualisierung einer veralteten Kern-Bibliothek abläuft:
Recherche & Spezifikationsabgleich
Der Agent liest die package.json, prüft Abhängigkeiten und konsultiert per MCP-Server oder Websuche die Migrationsleitfäden des Frameworks auf Breaking Changes.
Inkrementelle Code-Modifikation
Er führt das Update im Terminal aus und passt anschließend alle betroffenen Funktionsaufrufe über Dutzende Dateien hinweg synchron an die neue API-Signatur an.
Automatisierte Verifikation & Korrekturschleife
Er startet die Test-Suite. Schlagen Integrationstests fehl, analysiert er den Stack-Trace, identifiziert inkompatible Typ-Definitionen, behebt den Fehler und wiederholt die Tests, bis alle Checks grün sind.
6. Die 4 Architektur-Schichten im Detail
Um Multi-Agenten-Systeme stabil in ein Software-Unternehmen zu integrieren, bedarf es einer klaren Schichtenarchitektur. Jede Ebene erfüllt eine spezifische Schutz- und Steuerungsfunktion:
1. Spezifikation & Kontext-Governance
Definiert präzise Product Requirement Documents (PRDs), OpenAPI-Spezifikationen, TypeScript-Contracts und .cursorrules. Diese Schicht garantiert, dass Agenten niemals spekulieren müssen, sondern deterministische Vorgaben als Arbeitsgrundlage erhalten.
2. Orchestrierungs- & Routing-Ebene
Ein zentraler Supervisor-Agent (angetrieben von Reasoning-Modellen wie Claude 3.7 Sonnet oder Gemini 3.6 Flash) analysiert das Gesamtziel, zerlegt es in Teilaufgaben und delegiert diese an spezialisierte Subagenten für Coder, Refactorer oder Tester.
3. Tooling & MCP-Integrations-Layer
Stellt den Agenten sichere Werkzeuge über das Model Context Protocol (MCP) bereit. Ermöglicht Lese- und Schreibzugriffe auf Code-Repositories, Terminal-Sandboxes, Dokumentations-Server und Datenbanken unter strikter Rechteverwaltung.
4. Verifikations- & Quality-Gate
Automatisierte Evals, Unit-, Integrations- und End-to-End-Tests sowie Linters und SAST-Sicherheitsanalysen. Kein Code erreicht die Produktion oder den menschlichen Reviewer, ohne dieses Gate vollständig bestanden zu haben.
7. Interaktiver Benchmark: Frontier-Modelle im Coding-Test
Die Leistungsfähigkeit autonomer Software-Agenten hängt maßgeblich von den zugrunde liegenden KI-Modellen ab. Der anerkannte Industrie-Benchmark SWE-bench (Verified) misst, wie viele reale, nicht triviale GitHub-Issues Modelle vollkommen autonom durch Code-Änderungen und passende Tests lösen können. Unser interaktives Widget vergleicht die führenden Modelle:
8. Spec-Driven Engineering vs. „Vibe Coding“
Im Entwickler-Diskurs sorgt der Begriff „Vibe Coding“ für Aufsehen: Entwickler beschreiben lockere Ideen in natürlicher Sprache, lassen KIs den Code schreiben und testen das Ergebnis nur oberflächlich im Browser. Was für Wochenend-Projekte oder schnelle Prototypen verlockend klingt, ist für mittelständische Software-Unternehmen hochgradig gefährlich.
Im professionellen Umfeld führt unstrukturiertes Vibe Coding zu unkontrollierbarer technischer Schuld (Technical Debt), versteckten Sicherheitslücken und Code-Bloat. Sobald unklarer Code über hunderte Dateien verteilt wird, verliert das Team das konzeptionelle Verständnis über seine eigene Architektur. Verlässt ein Entwickler das Unternehmen, kann niemand mehr nachvollziehen, warum bestimmte Workarounds generiert wurden.
Die Antwort darauf ist Spec-Driven Agentic Engineering (SDAE). Statt Agenten unkontrolliert drauflos programmieren zu lassen, formulieren Ingenieure zuerst präzise Spezifikationen, Daten-Schemas, API-Verträge und Abnahmekriterien. Der Agent erhält ein klar abgegrenztes Problem mit überprüfbaren Randbedingungen. Er darf erst dann Code produzieren, wenn die Spezifikation vom Entwickler abgenommen wurde – und sein Code wird erst dann akzeptiert, wenn alle Spezifikations-Tests automatisiert bestehen. Disziplin schlägt Hype.
9. Die „Shipping-Lücke“: Warum mehr Code nicht mehr Produktivität bedeutet
Der Einsatz von KI-Agenten führt in Entwickler-Teams sofort zu einem messbaren Effekt: Das geschriebene Codevolumen steigt drastisch an. Aufgaben, für die Entwickler früher Stunden benötigten (wie das Schreiben von Boilerplate-Code, Standard-APIs oder Migrationsskripten), erledigen Agenten in wenigen Minuten.
Doch hier stoßen viele Unternehmen im Mittelstand auf ein paradoxes Phänomen, das Branchenanalysten als „Shipping-Lücke“ (Shipping Gap) bezeichnen: Obwohl die Teams dreimal so viel Code schreiben, stagniert die Anzahl der tatsächlich in Produktion gebrachten Features. Warum ist das so?
„Der Engpass der modernen Softwareentwicklung hat sich verschoben. Er liegt nicht mehr im Schreiben von Code, sondern im Verifizieren und Verstehen von Code.“
Wenn eine KI in fünf Minuten Code schreibt, der sich über zehn Dateien erstreckt, benötigt ein menschlicher Senior-Entwickler unter Umständen eine Stunde, um diesen Code im Code-Review (Pull Request) vollständig zu durchdringen, auf logische Konsistenz zu prüfen und freizugeben. Wird das Team unkritisch mit KI-generiertem Code überschwemmt, droht die Code-Qualität rapide zu sinken, während Entwickler zu reinen „PR-Review-Maschinen“ degradieren, die den Überblick über ihre eigene Systemarchitektur verlieren.
Der Schlüssel zur Schließung der Shipping-Lücke liegt in der automatisierten Verifikation. Ein Unternehmen kann das Potenzial von Coding Agents nur dann voll ausschöpfen, wenn es parallel in eine lückenlose Qualitätssicherung investiert. Agenten müssen so konfiguriert werden, dass sie ihren eigenen Code durch Unit-Tests, Integrationstests und statische Code-Analysen (Linters) verifizieren müssen, bevor ein Mensch den Code überhaupt zu Gesicht bekommt. Nur ein grüner, vollautomatisch verifizierter PR darf den Review-Prozess des menschlichen Entwicklers erreichen. Bei Agenten, die nicht Code, sondern Antworten produzieren, greift dasselbe Prinzip mit anderen Werkzeugen: Dort übernehmen Evals und messbare Abnahmekriterien die Rolle der Unit-Tests.
Experten-Tipp: Context-Optimierung mit .cursorrules
Die Qualität der Agenten-Ergebnisse steht und fällt mit dem bereitgestellten Kontext. Platzieren Sie im Root-Verzeichnis Ihres Projekts eine Datei namens .cursorrules (oder das Äquivalent des jeweiligen Tools). Definieren Sie dort präzise die Architektur-Muster Ihres Projekts (z. B. „Nutze ausschließlich Tailwind-Klassen für CSS, verwende TypeScript Strict-Mode, implementiere State-Management via Zustand“). Dies verhindert, dass Agenten veraltete oder unpassende Framework-Muster vorschlagen, und spart bis zu 40% Review-Zeit.
10. Risiken & Fallstricke im Unternehmenseinsatz
Der unkontrollierte Einsatz von AI Coding Assistants birgt signifikante Risiken in den Bereichen Finanzen, Sicherheit, Codequalität und Compliance. Unternehmen müssen diese Risikofaktoren aktiv managen.
Sicherheitslücken & Lizenzrisiken
Agenten können Sicherheitslücken (wie SQL-Injections, veraltete Krypto-Bibliotheken oder versehentlich hardcodierte API-Keys) in die Codebasis einbringen. Zudem besteht die Gefahr von Lizenzverletzungen, wenn die KI urheberrechtlich geschützten Code ohne Nennung der Lizenz (z. B. GPL) kopiert. Auch der Abfluss sensibler Algorithmen muss durch Zero-Data-Retention-Vereinbarungen mit den Modell-Anbietern unterbunden werden.
Code-Bloat & Software-Verfettung
Weil das Generieren von Code keine manuelle Tipp-Arbeit mehr erfordert, neigen Agenten dazu, Probleme durch das Hinzufügen von immer neuem Code zu lösen, anstatt bestehende Strukturen elegant zu refaktorieren. Es entstehen schwer wartbare Code-Monolithe. Ohne strikte Refactoring-Vorgaben steigen die langfristigen Wartungskosten (Technical Debt) drastisch an.
Kontrollverlust & Wissenserosion
Verlassen sich Entwickler blind auf die Vorschläge der Agenten, verlieren sie das tiefe Verständnis für die inneren Abläufe des eigenen Systems. Verlässt ein Senior-Entwickler das Unternehmen, kann das verbleibende Team den komplexen, KI-generierten Code bei kritischen Systemausfällen oft nicht mehr rechtzeitig debuggen. Das interne Software-Wissen verfällt.
11. Roadmap: Implementierung im Software-Team
Um Coding-Agenten sicher und produktiv in einem bestehenden Software-Team zu etablieren, empfiehlt sich ein strukturierter, vierteljährlicher Einführungsplan:
-
Phase 1: Tool-Evaluierung & Governance (Woche 1-3)
Wählen Sie die passenden Werkzeuge basierend auf Ihren Sicherheitsrichtlinien aus. Für hochsensible Kernbereiche evaluieren Sie On-Premise-Modelle (wie DeepSeek-R1 oder Qwen 2.5 Coder) oder Enterprise-Lizenzen mit strikten Datenschutzzusagen (keine Trainingsnutzung Ihrer Daten). Richten Sie lokale
.cursorrules-Dateien ein, um den architektonischen Rahmen abzustecken. -
Phase 2: Etablierung von Test-Pipelines & Linters (Woche 4-6)
Bevor Agenten produktiv eingesetzt werden, muss die lokale Test-Suite auf Vordermann gebracht werden. Implementieren Sie strenge, automatisierte Pre-Commit-Hooks und CI/CD-Pipelines (z. B. via GitHub Actions). Der Agent muss gezwungen werden, seinen Code lokal durch automatische Tests und Linters zu verifizieren, bevor ein PR erstellt werden darf.
-
Phase 3: Etablierung des „Human-in-the-Loop“-Reviews (Woche 7-9)
Definieren Sie klare Review-Prozesse. Jede KI-generierte Code-Änderung muss von mindestens einem menschlichen Senior-Entwickler freigegeben werden. Führen Sie stichprobenartige „Code-Audits“ durch, um sicherzustellen, dass keine unnötigen Code-Bloats oder Lizenzverletzungen in das Haupt-Repository fließen.
-
Phase 4: Multi-Agenten-Orchestrierung & CI/CD-Integration (Woche 10-12)
Integrieren Sie cloudbasierte, autonome Agenten (wie Devin oder Claude Code CLI-Pipelines) in Ihren Workflow. Lassen Sie Routine-Tickets (z. B. „Aktualisiere Bibliothek X“, „Behebe CSS-Darstellungsfehler auf Mobilgeräten“) direkt im Repository durch Agenten bearbeiten. Der Entwickler agiert nur noch als Product Owner, der die Anforderungen präzisiert und den fertigen PR freigibt.
12. Quick-Check vor dem Fazit
Prüfen Sie anhand der folgenden Checkliste, ob Ihr Entwicklungsteam bereit für den sicheren und produktiven Einsatz von Multi-Agenten-Systemen ist:
Quick-Check: Multi-Agenten-Readiness für Software-Teams
.cursorrules und Typsysteme (TypeScript) sichern den Code-Stil deterministisch ab.
13. Fazit & Ausblick: Der Entwickler als System-Orchestrator
Die Evolution der AI Coding Assistants von reaktiven Copilots zu autonomen Multi-Agenten-Systemen im Jahr 2026 ist kein vorübergehender Hype, sondern eine fundamentale Transformation unseres Berufsstandes. Sie löst den menschlichen Entwickler nicht ab, aber sie verändert seine Rolle radikal: Der Ingenieur der Zukunft schreibt weniger Code von Hand; er definiert Systemgrenzen, entwirft Software-Architekturen, schreibt präzise Verifikations-Tests und orchestriert Teams aus hochspezialisierten KI-Agenten.
Unternehmen im Mittelstand, die diese Transformation frühzeitig und strukturiert einleiten, werden ihre Innovationsgeschwindigkeit signifikant steigern, Entwicklungszyklen verkürzen und die Motivation ihrer Teams erhöhen, da monotone Fleißarbeit zunehmend von Maschinen erledigt wird. Der Schlüssel zum Erfolg liegt dabei nicht in blindem Vibe Coding, sondern in der eisernen Disziplin bei der Verifikation und der unermüdlichen Pflege der Software-Qualität.
Möchten Sie Multi-Agenten-Systeme in Ihrem Software-Team etablieren?
Wir analysieren Ihre bestehende Entwicklungs-Pipeline, etablieren sichere Verifikations-Gates und integrieren moderne KI-Agenten wie Cursor, Claude Code und MCP nahtlos in Ihre Workflows.
Kostenlose Erstberatung vereinbarenUnsere Expertise vor Ort
Wir sind Ihr digitaler Partner – regional verankert und überregional erfolgreich.

Haben Sie eine Vision?
Lassen Sie uns gemeinsam prüfen, wie wir Ihre Idee zum Fliegen bringen.
Jetzt kostenloses Strategiegespräch buchenErweitertes Fachglossar
Multi-Agenten-System
Ein Zusammenschluss mehrerer spezialisierter, autonomer KI-Agenten, die über definierte Schnittstellen miteinander interagieren und kooperieren. Jeder Agent besitzt eigene Werkzeuge und Rollen, um Teilaufgaben eines übergeordneten Ziels eigenständig zu lösen.
AI Coding Assistant
Software-Werkzeuge, die Entwickler bei der Programmierung unterstützen. Im Gegensatz zu einfachen Autocomplete-KIs können moderne, agentische Assistants Code-Änderungen über mehrere Dateien hinweg planen, ausführen, testen und Fehler selbstständig korrigieren.
Model Context Protocol (MCP)
Ein von Anthropic initiierter offener Standard, der es KI-Modellen und Agenten ermöglicht, über standardisierte Client-Server-Schnittstellen sicher auf externe Tools, Datenbanken, Repositories und Entwicklungsumgebungen zuzugreifen.
Human-in-the-Loop (HITL)
Ein Kontroll- und Sicherheitsprinzip, bei dem ein menschlicher Experte aktiv in den Entscheidungs- oder Freigabeprozess eines autonomen Systems eingebunden ist, um die Qualität zu sichern und Fehlentscheidungen der KI zu verhindern.
SWE-bench
Ein anerkannter Industrie-Benchmark zur Evaluierung von KI-Modellen bei der eigenständigen Lösung realer GitHub-Softwareprobleme (Bugfixes, Feature-Implementierungen und Test-Pass-Rates).
