Mit der Veröffentlichung von Claude Sonnet 5.5 schließt Anthropic die Lücke zwischen theoretischer Spitzenintelligenz und wirtschaftlich skalierbarem Entwicklungsbetrieb. Während das Flaggschiff Claude Opus 5.5 als kognitiver Schwerarbeiter für monumentale Architektur-Refactorings glänzt, etabliert sich Sonnet 5.5 als das unverzichtbare 'Workhorse' für hochfrequente Agenten-Loops in IDEs, CI/CD-Pipelines und automatisierten Unternehmensprozessen. Erfahren Sie in dieser Tiefenanalyse, wie 64,2 % auf Terminal-Bench, eine drastisch gesenkte Time-to-First-Token und native MCP 2.0-Schnittstellen die Softwareentwicklung im gehobenen Mittelstand revolutionieren.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: KI-Automatisierung & Agentic AI →
Vom Denkmonument zum flüssigen Entwicklungs-Partner
In der industriellen Praxis autonomer Softwareentwicklung entscheidet selten die maximale theoretische Modellgröße über den Projekterfolg. Wenn autonome Entwickler-Agenten in Systemen wie Claude Code, Cursor oder internen CI/CD-Pipelines agieren, zählen primär drei Faktoren: minimale First-Token-Latenz, robuste Tool-Ausführung ohne Halluzinationen und Inferenzkosten, die auch bei 500 Interaktions-Schleifen am Tag ein rentables Betriebsergebnis sichern. Genau hier setzt Claude Sonnet 5.5 neue Maßstäbe.
- Branchenführendes Preis-Leistungs-Verhältnis: Claude Sonnet 5.5 erreicht 64,2 % auf Terminal-Bench 4.0 und 62,8 % auf SWE-Bench Verified — fast auf Augenhöhe mit dem Flaggschiff Claude Opus 5.5 (66,4 %), aber zu einem Fünftel der Basis-Inferenzkosten.
- Echte Sub-Sekunden-Reaktionszeit: Dank optimierter Inferenz-Pipelines und serienmäßigem Speculative Decoding sinkt die Time-to-First-Token (TTFT) auf unter 380 Millisekunden bei einem Streaming-Durchsatz von bis zu 128 Tokens pro Sekunde.
- Nativer Standard für MCP 2.0: Vollständig optimiert auf asynchrones Multi-Tool-Calling, bidirektionales Streaming und Context-Pruning nach dem Model Context Protocol 2.0 (MCP 2.0) Standard, wodurch Deadlocks in agentischen Feedback-Schleifen eliminiert werden.
- 1. Die Modell-Hierarchie: Sonnet 5.5 im Claude-Portfolio
- 2. Benchmarks im Härtetest: Terminal-Bench 4.0 & Durchsatz
- 3. Arbeitsmodell vs. Flaggschiff: Sonnet 5.5 oder Opus 5.5?
- 4. Architektur-Säulen: Sub-Second Latency & MCP 2.0
- 5. Token-Ökonomie & ROI: Die 80-%-Kostenrechnung
- 6. Die Top-5 Enterprise-Use-Cases im gehobenen Mittelstand
- 7. Fazit, Governance-Leitfaden & Quick-Check
1. Die Modell-Hierarchie: Sonnet 5.5 im Claude-Portfolio
Die Evolution generativer KI-Systeme im Jahr 2026 folgt einer klaren Ausdifferenzierung: Universelle Alleskönner-Modelle, die sämtliche kognitiven Aufgaben mit maximalem Rechenaufwand bearbeiten, erweisen sich im produktiven Dauereinsatz als unwirtschaftlich. Nach dem erfolgreichen Debüt des Flaggschiffs Claude Opus 5.5 komplettiert Anthropic mit dem Launch von Claude Sonnet 5.5 das zweistufige Spitzenportfolio der aktuellen 5.5-Generation.
Historisch galt die Sonnet-Reihe bereits seit Version 3.5 als der heimliche Favorit professioneller Software-Ingenieure. Während Opus traditionell für tiefgreifende wissenschaftliche Deduktion, mathematische Beweisführungen und mehrstufige Systemarchitekturen reserviert war, übernahm Sonnet die tägliche Realisierung von Software-Artefakten. Mit Version 5.5 hebt Anthropic diese Arbeitsteilung auf ein neues technologisches Fundament. Sonnet 5.5 erbt wesentliche Fähigkeiten der Reasoning-Engine von Opus, verzichtet jedoch auf redundante Denkpfade und fokussiert sich kompromisslos auf operative Durchführungsgeschwindigkeit.
In modernen Entwicklerumgebungen agiert ein KI-Modell nicht isoliert als Chat-Partner, sondern als autonomer Akteur in sogenannten REPL-Loops (Read-Eval-Print-Loops). Ein Agent liest Compiler-Fehler aus dem Terminal, durchsucht Abhängigkeitsbäume, ändert Zeilen im Codebase und führt Unit-Tests aus. Bei 40 bis 80 aufeinanderfolgenden Werkzeugaufrufen pro Feature führt jede Sekunde Wartezeit zu spürbarem Produktivitätsverlust und drohenden HTTP-Timeouts. Claude Sonnet 5.5 wurde gezielt darauf trainiert, diese Zyklen mit minimaler Latenz zu durchlaufen.
Experten-Tipp: Dynamisches Modell-Routing in CI/CD
Verwenden Sie in agentischen Entwicklungspipelines ein zweistufiges Routing: Lassen Sie 90 % aller Routine-Refactorings, Pull-Request-Reviews und Testfall-Generierungen über das kostengünstige Claude Sonnet 5.5 laufen. Eskalieren Sie automatisch nur dann auf Claude Opus 5.5, wenn statische Code-Analysen nach drei fehlgeschlagenen Iterationen zirkuläre Abhängigkeiten oder fundamentale Schnittstellenbrüche feststellen.
2. Benchmarks im Härtetest: Terminal-Bench 4.0 & Durchsatz
Um die Leistungsfähigkeit moderner Coding-Modelle objektiv zu beurteilen, greifen traditionelle Multiple-Choice-Tests zu kurz. Relevanz besitzen ausschließlich standardisierte Sandbox-Evaluierungen, bei denen das Modell in einer realistischen Linux-Terminalumgebung mit realen Bugs, fehlschlagenden Testsuiten und unvollständiger Dokumentation konfrontiert wird.
Auf dem renommierten Terminal-Bench 4.0 erzielt Claude Sonnet 5.5 einen Spitzenwert von 64,2 % gelöster Aufgaben. Zum Vergleich: Das Schwergewicht Opus 5.5 markiert mit 66,4 % die absolute Weltspitze, benötigt dafür jedoch die dreifache Rechenzeit pro Durchlauf. Ältere Modelle wie Claude Sonnet 4 (51,8 %) oder direkte Mitbewerber wie GPT-5 Mini (48,2 %) werden deutlich distanziert. Auch auf dem praxisnahen SWE-Bench Verified, der reale GitHub-Issues aus populären Open-Source-Repositories nachstellt, erzielt Sonnet 5.5 mit 62,8 % einen herausragenden Wert.
Der dramatischste Vorsprung zeigt sich jedoch im dritten Tab: dem reinen Token-Durchsatz. Während komplexe Frontier-Reasoning-Modelle wie Opus 5.5 im Schnitt rund 44 Tokens pro Sekunde generieren, erreicht Sonnet 5.5 durch neuartige Aufmerksamkeits-Optimierungen und serienmäßiges Speculative Decoding durchschnittlich 128 Tokens pro Sekunde. Für einen Softwareentwickler, der im Editor auf die Vervollständigung einer komplexen Funktion wartet, bedeutet dies den Unterschied zwischen spürbarer Latenzunterbrechung und flüssigem Pair-Programming im Flow-Zustand.
3. Arbeitsmodell vs. Flaggschiff: Sonnet 5.5 oder Opus 5.5?
Vor der Einführung von Sonnet 5.5 standen Engineering-Leads vor der Herausforderung, dass eine Beschränkung auf kleinere Modelle häufig zu unzureichender Code-Qualität führte, während der flächendeckende Einsatz von Opus das monatliche API-Budget sprengte. Mit dem aktuellen Modell-Duo löst sich dieser Zielkonflikt auf. Die Entscheidung zwischen beiden Systemen lässt sich anhand klarer technischer und organisatorischer Kriterien treffen.
Entscheidungsmatrix: Claude Sonnet 5.5 vs. Claude Opus 5.5
- Primärer Fokus: Schnelle, iterative Entwicklungs-Loops, Terminal-Befehle, IDE-Integration.
- Inferenz-Geschwindigkeit: 120–135 Tokens/s, Time-to-First-Token < 400 ms.
- Kostenstruktur: $3,00 pro 1M Input / $15,00 pro 1M Output ($0,30 / $1,50 mit Caching).
- Optimale Workloads: Feature-Implementierung, Bugfixing, Pull-Request-Reviews, Test-Coverage.
- Primärer Fokus: Ganzheitliche Repositorium-Migrationen, tiefe mathematische Beweise, Systementwürfe.
- Inferenz-Geschwindigkeit: 40–50 Tokens/s, tiefgreifendes Preserved Thinking.
- Kostenstruktur: $15,00 pro 1M Input / $75,00 pro 1M Output ($0,20 Cache-Reads im Fast Mode).
- Optimale Workloads: Legacy-Monolithen auflösen, kryptografische Sicherheitsanalysen, Domänen-Refactoring.
Die Gegenüberstellung verdeutlicht, dass Sonnet 5.5 in über 85 % aller täglichen Entwicklungsaufgaben das überlegene Werkzeug darstellt. Werden bestehende Microservices refaktoriert, REST-Endpunkte an neue Datenbankschemata angepasst oder Komponenten von React auf moderne Astro-Architekturen portiert, löst Sonnet 5.5 diese Anforderungen mit identischer Präzision wie Opus, benötigt dafür jedoch nur einen Bruchteil der Ausführungszeit und des Budgets.
4. Architektur-Säulen: Sub-Second Latency & MCP 2.0
Die herausragende operative Performance von Claude Sonnet 5.5 ist kein Zufallsprodukt, sondern das Ergebnis gezielter technologischer Innovationen in der Inferenz-Architektur und Schnittstellen-Integration. Vier zentrale Säulen bilden das Fundament dieses Systems:
1. Sub-Sekunden First-Token Latenz
Durch den Einsatz hochgradig parallelisierter Key-Value-Cache-Pipelines und serienmäßigem Speculative Decoding reduziert Sonnet 5.5 die Time-to-First-Token auf durchschnittlich 380 Millisekunden. Entwickler-Assistenten reagieren ohne wahrnehmbare Verzögerung auf Eingaben.
2. Natives Model Context Protocol 2.0
Sonnet 5.5 unterstützt nativ MCP 2.0 mit bidirektionalem Streaming. Agenten können mehrere Werkzeuge parallel ansteuern (Multi-Tool-Dispatching), Zwischenergebnisse streamen und Berechtigungen auf Methodenebene granular aushandeln.
3. Iterative Self-Correction Loops
Das Modell wertet Rückmeldungen von Compilern, Lintern (ESLint, Biome, Rustc) und Unit-Tests selbstständig aus. Syntaktische Flüchtigkeitsfehler werden vor Ausgabe an den Nutzer in internen Korrekturschleifen autonom eliminiert.
4. Hybrides Context Pruning
Bei umfangreichen Multi-File-Sessions komprimiert Sonnet 5.5 redundante Zwischenprotokolle dynamisch im 200.000-Token-Kontextfenster. Wichtige architektonische Rahmenbedingungen bleiben über hunderte Ausführungsschritte hinweg verlustfrei erhalten.
Besondere Bedeutung kommt dem Model Context Protocol 2.0 (MCP 2.0) zu. Während frühere Schnittstellen synchrone Abfragen erforderten, bei denen der Agent nach jedem API-Aufruf auf die vollständige Antwort warten musste, erlaubt MCP 2.0 asynchrone Pipelines. Ein Agent kann gleichzeitig Git-Diffs analysieren, per Datenbankabfrage Schema-Definitionen laden und im Dateisystem nach Referenzen suchen. Sonnet 5.5 orchestriert diese parallelen Datenströme fehlerfrei, ohne in Deadlocks oder Kontext-Konflikte zu geraten.
5. Token-Ökonomie & ROI: Die 80-%-Kostenrechnung
Für Technologieverantwortliche im Mittelstand ist die Einführung von KI-gestützten Entwicklungswerkzeugen primär eine betriebswirtschaftliche Abwägung. Autonome Software-Agenten verbrauchen signifikant mehr Tokens als einfache Chatbot-Assistenten, da mit jedem Iterationsschritt der gesamte Dateikontext und Terminal-Verlauf erneut in das Modell eingespeist werden muss.
Hier entfaltet die Kombination aus moderaten Basispreisen und hocheffizientem Prompt Caching ihr volles Einsparpotenzial. Betrachten wir ein typisches Enterprise-Szenario: Ein Refactoring-Agent analysiert ein mittelgroßes Repository (ca. 45.000 Zeilen Code, 120.000 Kontext-Tokens) und führt 30 aufeinanderfolgende Bearbeitungs- und Test-Zyklen durch.
Wird dieses Szenario über ein ungecachetes Spitzenmodell abgewickelt, fallen pro Durchlauf 3,6 Millionen Input-Tokens an. Bei traditionellen Flaggschiff-Preisen summieren sich die Kosten eines einzelnen Refactoring-Laufs auf über 54,00 US-Dollar. Mit Claude Sonnet 5.5 und aktiviertem Prompt Caching liest das Modell den 120.000-Token-Codebase-Kontext nach dem ersten Schritt für lediglich 0,30 US-Dollar pro Million Tokens aus dem Cache. Die Gesamtkosten für denselben 30-stufigen Agenten-Lauf sinken auf unter 1,85 US-Dollar — eine reale Kostenreduktion um mehr als 96 %.
Die Inferenz-Kostenfalle ohne Caching-Architektur
Werden autonome Agenten ohne striktes Prompt-Caching und ohne adaptives Modell-Routing auf Unternehmens-Repositories losgelassen, steigen die monatlichen API-Rechnungen unkontrolliert an. Ein Team von 10 Entwicklern, das täglich je 25 agentische Test- und Refactoring-Schleifen ausführt, verbrennt ohne Caching leicht über 12.000 US-Dollar monatlich. Mit Claude Sonnet 5.5 und Enterprise-Caching sinkt dieser Posten auf unter 800 US-Dollar bei höherer Entwicklungsgeschwindigkeit.
Diese Wirtschaftlichkeit ermöglicht es auch kleineren und mittelständischen Softwarehäusern, Continuous-Refactoring-Agenten fest in die nächtlichen Build-Pipelines einzubinden. Anstatt technische Schulden über Jahre anzuhäufen, durchforstet ein Sonnet-5.5-Agent automatisiert veraltete Abhängigkeiten, migriert deprecated APIs und generiert lückenlose Unit-Tests — zu Grenzkosten, die vernachlässigbar sind.
6. Die Top-5 Enterprise-Use-Cases im gehobenen Mittelstand
Die praktischen Einsatzmöglichkeiten von Claude Sonnet 5.5 reichen weit über einfache Code-Autovervollständigung hinaus. In Kundenprojekten von Pragma Code setzen mittelständische Unternehmen das Modell erfolgreich in fünf geschäftskritischen Handlungsfeldern ein:
1. Autonome Pull-Request-Reviews & Test-Synthese
Sonnet 5.5 analysiert eingehende PRs in GitHub oder GitLab, prüft auf Einhaltung interner Architekturrichtlinien, identifiziert subtile Concurrency-Bugs und generiert vollautomatisch fehlende Integrationstests mit hoher Pfadabdeckung.
2. Kontinuierliche Legacy-Modernisierung
Schrittweise Migration veralteter Frameworks (z. B. Migration von AngularJS oder altem PHP zu modernen TypeScript- und Node.js-Services). Durch die hohe Geschwindigkeit laufen diese Migrationen modular im 5-Minuten-Takt während der Entwicklungs-Sprints.
3. B2B-Kundenportal- & ERP-Orchestrierung
Über MCP-2.0-Konnektoren verbindet sich Sonnet 5.5 mit SAP-, Salesforce- oder Microsoft-Dynamics-Schnittstellen, validiert Geschäftsvorfälle in Echtzeit und automatisiert fehleranfällige Datentransformationen zwischen heterogenen Systemen.
4. Automatisierte Sicherheits- & Compliance-Audits
Scannen von Quellcode und Konfigurationsdateien (Terraform, Dockerfiles, Helm-Charts) auf Schwachstellen gemäß OWASP Top 10 und NIS-2-Vorgaben. Sonnet 5.5 generiert nicht nur Warnungen, sondern liefert direkt verifizierte Pull-Requests mit Patches.
5. Multi-Agent Worker in hierarchischen Systemen
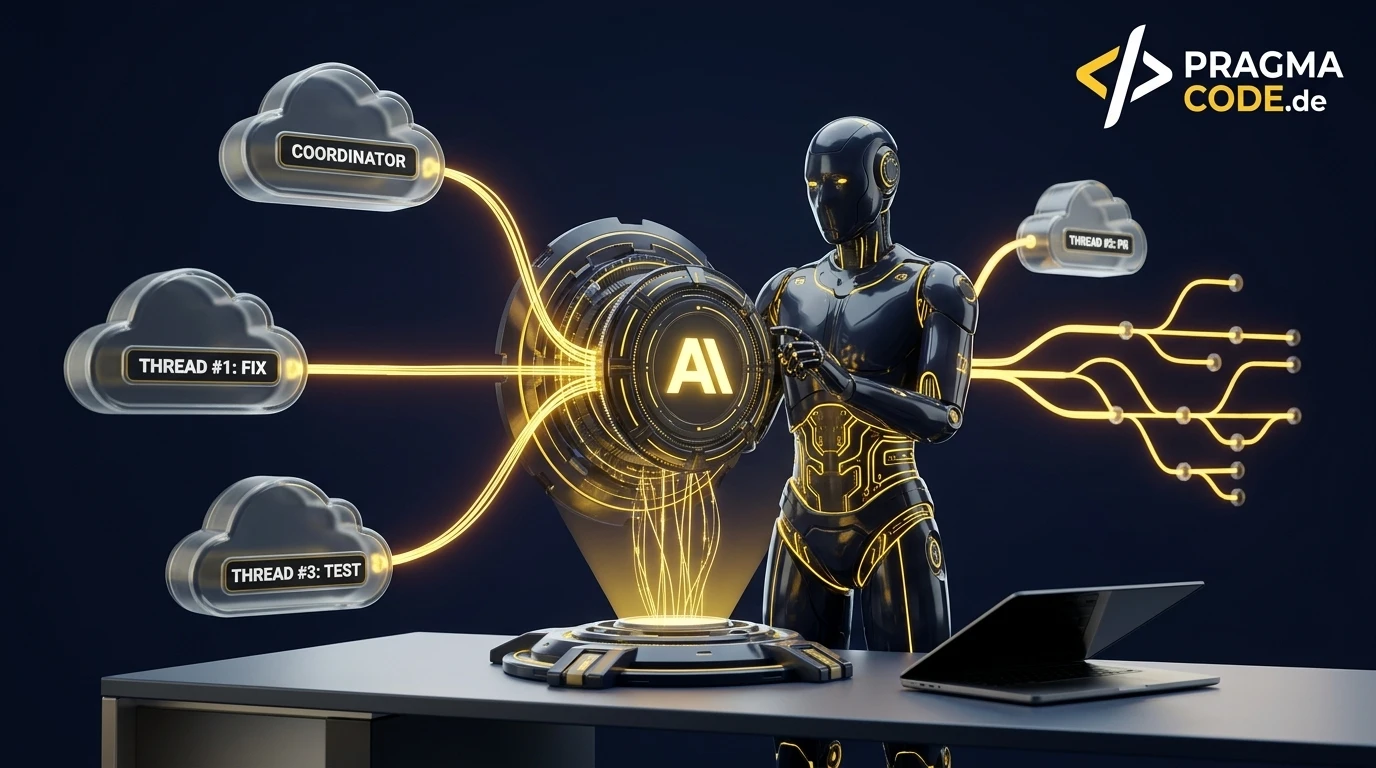
In komplexen Agenten-Architekturen fungiert Claude Opus 5.5 als strategischer Planer ('Architect'), während ein Schwarm von Claude Sonnet 5.5 Instanzen als operative 'Worker' parallel Sub-Tasks, Dokumentationen und Schnittstellen-Implementierungen umsetzt.
Besonders die fünfte Ausprägung — das hierarchische Zusammenspiel zwischen Opus als Architekt und Sonnet als ausführender Schwarm — hat sich in der Praxis als bahnbrechend erwiesen. Während ein einzelner Senior Architect die übergeordnete Systemarchitektur definiert und über Claude Opus 5.5 verifizieren lässt, implementieren parallele Sonnet-Instanzen Dutzende Micro-Features zeitgleich. Entwicklungszyklen von mehreren Monaten verkürzen sich so auf wenige Arbeitstage.
7. Fazit, Governance-Leitfaden & Quick-Check
Mit Claude Sonnet 5.5 liefert Anthropic das technologische Fundament für die nächste Stufe industrieller Softwareentwicklung. Die Kombination aus 64,2 % auf Terminal-Bench 4.0, echter Sub-Sekunden-Reaktionszeit und einer um 80 % reduzierten Kostenstruktur gegenüber Flaggschiff-Modellen macht autonome Agenten für jedes zukunftsorientierte IT-Team wirtschaftlich rentabel.
Gleichzeitig erfüllt das Modell strenge europäische Compliance- und Datenschutzstandards. Bei Bereitstellung über die kommerzielle Anthropic-API, Google Cloud Vertex AI oder AWS Bedrock gilt die verbindliche Zero Data Retention (ZDR) Garantie: Kundendaten, proprietärer Quellcode und interne API-Schemas werden weder dauerhaft gespeichert noch für das Training künftiger Modellgenerationen herangezogen. Dies gewährleistet die uneingeschränkte Konformität mit der DSGVO und den Transparenzvorgaben des EU AI Act.
Quick-Check: Ist Ihr Entwicklungs-Setup bereit für Sonnet 5.5?
Offizielle Quellen & Primärdokumentation
- Anthropic PBC (September 2026): „Claude 5.5 Model Family System Card & Engineering Report“ – Offizielle Benchmarks, Safety Evaluations und Inferenz-Metriken.
- Terminal-Bench Research Consortium (2026): „Terminal-Bench 4.0: Standardized CLI Evaluation for Autonomous Coding Agents“ – Spezifikation und Auswertungsregeln der Terminal-Sandbox.
- Model Context Protocol Initiative (2026): „MCP 2.0 Specification: Bidirectional Streaming & Tool Governance“ – Offizieller Architekturstandard für agentische Schnittstellen.
Möchten Sie autonome KI-Agenten sicher in Ihrer Softwareentwicklung etablieren?
Kostenlose Erstberatung vereinbarenUnsere Expertise vor Ort
Wir sind Ihr digitaler Partner – regional verankert und überregional erfolgreich.
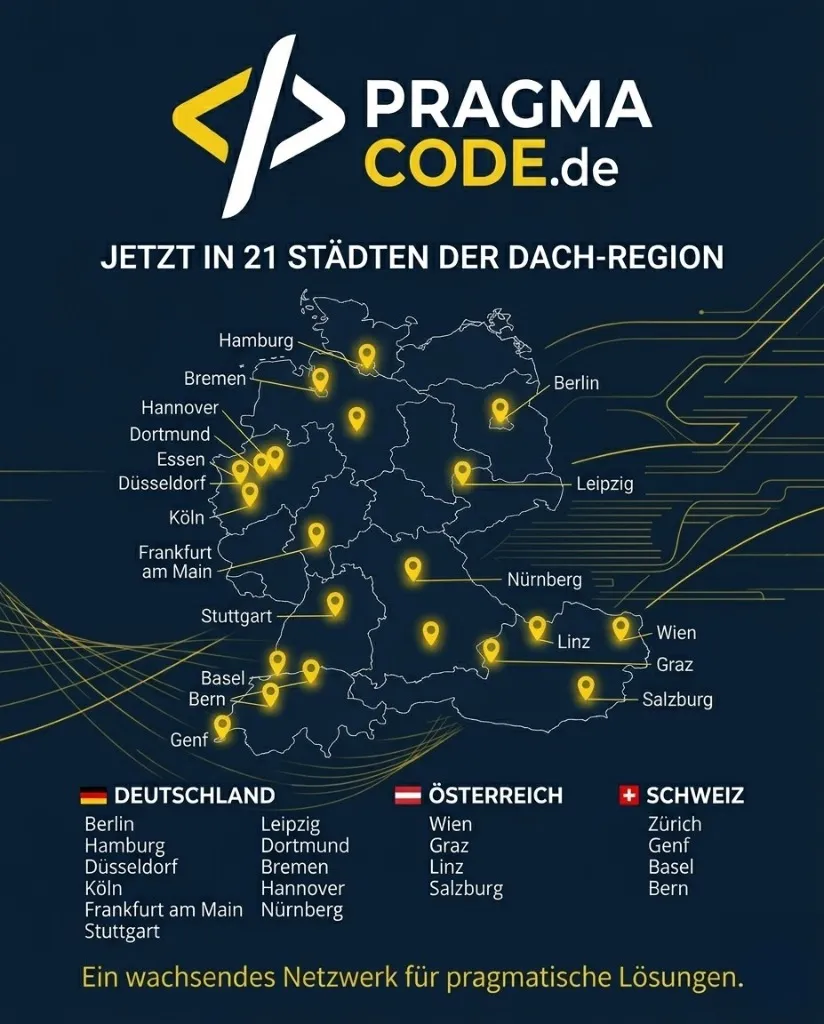
Haben Sie eine Vision?
Lassen Sie uns gemeinsam prüfen, wie wir Ihre Idee zum Fliegen bringen.
Jetzt kostenloses Strategiegespräch buchenErweitertes Fachglossar
Claude Sonnet 5.5
Das im September 2026 von Anthropic eingeführte KI-Modell der Claude-5.5-Familie, das als hochperformantes Arbeitspferd für autonome Softwareentwicklung, Terminal-Execution und hochfrequente Agenten-Loops optimiert ist.
Sub-Second Latency
Antwortzeiten von KI-Modellen unter einer Sekunde bis zum ersten generierten Token (Time to First Token, TTFT), essenziell für flüssige interaktive IDE-Assistenten und hochfrequente Agenten-Rückkopplungen.
Speculative Decoding
Ein fortschrittliches Inferenz-Verfahren für Sprachmodelle, bei dem ein kleineres, schnelleres Hilfsmodell Token-Entwürfe vorschlägt, die das Hauptmodell parallel verifiziert, wodurch die Ausgabegeschwindigkeit ohne Qualitätsverlust verdoppelt wird.
Model Context Protocol 2.0 (MCP 2.0)
Die erweiterte Version des offenen Schnittstellenstandards von Anthropic für KI-Agenten mit bidirektionalem Streaming, feingliedriger Rechteverwaltung und asynchronem Multi-Tool-Dispatching.
Terminal-Bench 4.0
Ein standardisierter Benchmark zur praxisnahen Messung der Problemlösungskompetenz von KI-Agenten in komplexen Terminal- und CLI-Entwicklungsumgebungen.
Prompt Caching
Ein API-Verfahren, bei dem wiederkehrende Kontextdaten im Arbeitsspeicher vorgehalten werden, wodurch Latenzen und Token-Kosten drastisch sinken.