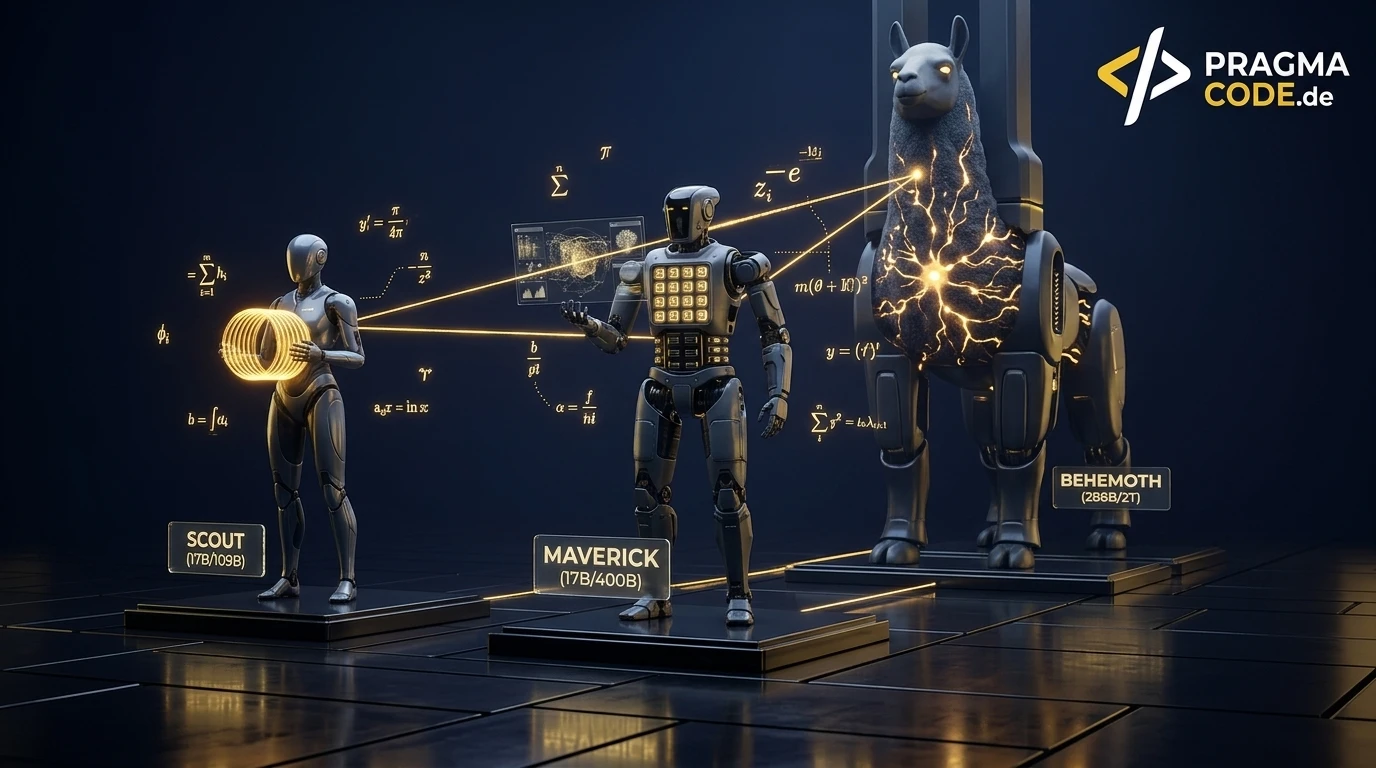
Mit Llama 4 bricht Meta endgültig mit der Tradition monolithischer Dense-Modelle. Die neue Modellfamilie aus Scout, Maverick und Behemoth setzt auf eine radikale Mixture-of-Experts-Architektur (MoE), ein revolutionäres 10-Millionen-Token-Kontextfenster und native Multimodalität. Warum diese Open-Weights-Modelle die Spielregeln für europäische Unternehmen verändern und wie der Mittelstand proprietären Cloud-Silos entkommt.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite:KI-Automatisierung & KI-Agenten →
Der Wendepunkt für Enterprise Open Weights
Mit Llama 4 verabschiedet sich Meta endgültig vom Paradigma gigantischer Dense-Modelle. Durch die konsequente Einführung von Sparse MoE (Mixture of Experts) und extremer Kontextskalierung bis zu 10 Millionen Tokens erreicht Open-Weights-Software erstmals ein Effizienz- und Leistungsniveau, das bisher geschlossenen US-Hyperscaler-APIs vorbehalten war. Für europäische Unternehmen eröffnet dies den direkten Weg zu vollständiger digitaler Souveränität.
- Paradigmenwechsel zu Sparse MoE: Sowohl Llama 4 Scout (109B) als auch Llama 4 Maverick (400B) aktivieren pro Token lediglich 17 Milliarden Parameter (Active Parameters). Dies ermöglicht Inferenzgeschwindigkeiten und Kostenstrukturen kompakter Modelle bei der Intelligenzdichte von Großmodellen.
- 10-Millionen-Token-Durchbruch auf Standard-Hardware: Dank Interleaved Attention und iRoPE bewältigt Llama 4 Scout vollständige Firmen-Repositories oder jahrzehntelange Vertragsarchive auf einer einzelnen NVIDIA H100 GPU (FP8) – ohne fragmentierte RAG-Pipelines.
- Souveräne Enterprise-Unabhängigkeit: Mit Llama 4 realisieren mittelständische Unternehmen hochgradig autonome Multi-Agenten-Systeme und multimodale Prozessketten vollständig On-Premise – 100 % DSGVO-konform und immun gegen API-Preiserhöhungen oder US-Cloud-Abhängigkeiten.
- 1. Der Paradigmenwechsel von Dense zu MoE: Warum Llama 4 die Spielregeln neu schreibt
- 2. Die Modell-Familie im Röntgenblick: Scout, Maverick und Behemoth
- 3. Deep Dive Scout: Das 10-Millionen-Token-Wunder auf einer einzelnen H100
- 4. Deep Dive Maverick: 128 Experten, native Multimodalität & Agentic Coding
- 5. Deep Dive Behemoth: Das 2-Billionen-Frontier-Modell als Wissens-Destillations-Motor
- 6. Benchmark-Härtetest: Llama 4 im direkten Leistungsvergleich
- 7. Enterprise-Architektur & Hardware-Sizing: VRAM-Kalkulation und vLLM-Hosting
- 8. Datenschutz & Compliance: DSGVO und EU AI Act ohne Hyperscaler-Risiko
- 9. Implementierungs-Roadmap: In 5 Phasen zum produktiven MoE-Stack
- 10. Quick-Check & Fazit: Warum der Mittelstand jetzt auf Llama 4 setzen sollte
1. Der Paradigmenwechsel von Dense zu MoE: Warum Llama 4 die Spielregeln neu schreibt
Über Jahre hinweg folgte die Entwicklung generativer Sprachmodelle einem einfachen, aber ressourcenhungrigen Prinzip: Skalierung der dichten Parameteranzahl (Dense Scaling). Bei einem klassischen Modell wie Llama 3 mit 70 Milliarden Parametern muss für jedes einzelne erzeugte Wort exakt das gesamte neuronale Netz mit allen 70 Milliarden Parametern durchlaufen werden. Was auf Forschungsebene beeindruckende Benchmarks lieferte, führte in der betrieblichen Praxis zu massiven wirtschaftlichen Hürden: astronomischer GPU-Speicherbedarf, hohe Stromkosten, explodierende Cloud-Rechnungen und träge Antwortzeiten bei gleichzeitigen Nutzeranfragen.
Mit der Veröffentlichung der Llama-4-Familie vollzieht Meta denselben radikalen architektonischen Schnitt, den zuvor spezialisierte Vorreiter wie Mistral oder DeepSeek eingeleitet haben: den vollständigen Übergang zu einer Mixture of Experts (MoE) Architektur. Anstatt ein monolithisches Netzwerk zu befeuern, teilt Llama 4 die Feed-Forward-Schichten in eine Vielzahl hochspezialisierter Teilnetzwerke (Experten) auf. Ein lernfähiger Gating-Mechanismus – das sogenannte Sparse Routing – entscheidet dynamisch für jedes einzelne Token, welche wenigen Experten zur Berechnung herangezogen werden.
Das Resultat ist eine drastische Entkopplung von Gesamtkapazität und Rechenaufwand: Ein Modell kann das akkumulierte Wissen von mehreren hundert Milliarden Parametern im Speicher vorhalten, benötigt zur Ausführung jedoch nur einen Bruchteil der Rechenleistung (FLOPs). Für den europäischen Mittelstand markiert dieser Schritt eine Zeitenwende. Enterprise-taugliche KI verlässt das Reich unerreichbarer Rechenzentrums-Cluster und wird auf standardisierter Industrie-Hardware im eigenen Serverraum oder bei lokalen Colocation-Partnern wirtschaftlich betreibbar.
Parallel dazu durchbricht Llama 4 eine zweite fundamentale Barriere: die Begrenzung des Kontextfensters. Während frühere Generationen bei 8.000 bis 128.000 Tokens an ihre mathematischen und speichertechnischen Grenzen stießen, operiert das Scout-Modell standardmäßig mit bis zu 10 Millionen Tokens. Dadurch entfällt in vielen Anwendungsfällen die fehleranfällige Notwendigkeit, Dokumente in künstliche Text-Chunks zu zerlegen. Komplette Softwaresysteme, historische ERP-Audit-Trails oder mehrbändige technische Handbücher können am Stück im Arbeitsgedächtnis des Modells verarbeitet werden.
2. Die Modell-Familie im Röntgenblick: Scout, Maverick und Behemoth
Meta strukturiert die Llama-4-Generation nicht mehr nach reiner Parametergröße wie früher (8B, 70B, 405B), sondern nach klar definierten Einsatzprofilen, Inferenz-Budgets und betriebswirtschaftlichen Rollen. Die drei Säulen der Modellfamilie bilden ein synergistisches Ökosystem, das von der leichtgewichtigen Edge-Inferenz bis zur wissenschaftlichen Spitzenforschung reicht.
Vergleich: Die drei Säulen der Llama-4-Generation
- Gesamt-Parameter: 109 Milliarden Gesamtgewichte
- Aktive Parameter: 17 Milliarden pro Token (16 Experten)
- Kontextfenster: 10 Millionen Tokens (iRoPE & Interleaved)
- Hardware-Ziel: Single-Node Inferenz (1x NVIDIA H100 80GB FP8)
- Fokus-Workflows: RAG-freie Dokumentenanalyse, Codebase-Audits, Realtime-Support
- Gesamt-Parameter: 400 Milliarden Gesamtgewichte
- Aktive Parameter: 17 Milliarden pro Token (128 Experten)
- Kontextfenster: 1 Million Tokens nativer Kontext
- Hardware-Ziel: Multi-GPU-Cluster (4x bis 8x H100/H200 FP8)
- Fokus-Workflows: Autonome Agentic Pipelines, Software-Engineering, multimodale Diagnose
Ergänzt werden diese beiden frei herunterladbaren Produktionsmodelle durch Llama 4 Behemoth: ein gigantisches Frontier-Modell mit rund 2 Billionen Parametern (~2T Gesamt, ~288B aktiv bei 16 Experten). Behemoth fungiert primär als forschungsgetriebenes Lehrermodell (Teacher Model). Durch hochentwickelte Knowledge Distillation und die Generierung synthetischer Trainingsdaten auf Weltklasse-Niveau überträgt Meta das logische Abstraktionsvermögen dieses Riesen auf die schlankeren Modelle Scout und Maverick.
Um die technischen Grundlagen dieser drei Systeme zu verstehen, lohnt sich ein Blick auf die vier tragenden Architektursäulen, die Llama 4 von allen früheren Open-Source-Veröffentlichungen abheben:
1. Dynamic Top-k Router
Ein token-basiertes Gating-Netzwerk berechnet Softmax-Wahrscheinlichkeiten über alle verfügbaren Experten. Es werden strikt nur die relevantesten Teilnetzwerke aktiviert, was den Rechenaufwand pro Token auf konstant 17B begrenzt.
2. Interleaved Attention & iRoPE
Verknüpfung von lokaler Sliding-Window-Attention mit zyklischen globalen Full-Attention-Ebenen. Ergänzt durch iRoPE verhindert das System Attention-Drift und hält den Speicherbedarf des KV-Caches linear im Zaum.
3. Native Early-Fusion
Bilder, technische Zeichnungen und Videosequenzen werden nicht über nachträglich angeflanschte Vision-Adapter verarbeitet, sondern von Beginn an im einheitlichen Token-Raum mit Textdaten tokenisiert und trainiert.
4. Teacher Distillation Pipeline
Das 2-Billionen-Modell Behemoth erzeugt hochqualitative Chain-of-Thought-Begründungsketten, mathematische Beweise und verifizierte Code-Synthesen, mit denen Scout und Maverick feingetunt wurden.
3. Deep Dive Scout: Das 10-Millionen-Token-Wunder auf einer einzelnen H100
Für die Mehrheit aller Enterprise-Workflows ist Llama 4 Scout das strategisch bedeutendste Modell der gesamten Familie. Die mathematische Meisterleistung von Scout liegt in der extremen Spezialisierung auf Inferenz-Effizienz und Langkontext-Verarbeitung. Mit insgesamt 109 Milliarden Parametern, verteilt auf 16 Experten, von denen pro Token exakt zwei ausgewählt werden (Top-2 Routing), beläuft sich der aktive Rechenaufwand auf lediglich 17 Milliarden Parameter.
Das herausragende Merkmal von Scout ist sein Kontextfenster von unglaublichen 10 Millionen Tokens. Um diese Dimension greifbar zu machen: 10 Millionen Tokens entsprechen rund 7,5 Millionen Wörtern oder etwa 25.000 DIN-A4-Seiten Fließtext. Bisherige Versuche, solche Kontextlängen in Transformer-Modellen zu erreichen, scheiterten an zwei massiven physikalischen Schranken: der quadratischen Komplexität der Standard-Attention $O(N^2)$ und dem exponentiellen Speicherhunger des Key-Value-Caches (KV Cache).
Meta löst dieses Problem in Scout durch eine zweistufige Innovation:
-
Architektur-Stufe 1: Interleaved Sparse Attention
Statt in jedem der 48 Transformer-Layer eine globale Aufmerksamkeit über alle 10 Millionen Tokens zu berechnen, nutzt Scout in 85 % aller Schichten eine lokale Sliding-Window-Attention mit einer Fenstergröße von 8.192 Tokens. Nur in jeder sechsten Schicht greift eine globale Attention-Ebene. Dies reduziert die Speicherbandbreite drastisch, ohne den globalen Informationsfluss zwischen weit entfernten Textabschnitten zu kappen.
-
Architektur-Stufe 2: Interleaved Rotary Position Embeddings (iRoPE)
Klassische RoPE-Verfahren leiden bei extrem langen Sequenzen unter Frequenzauflösungsverlusten, die dazu führen, dass das Modell Informationen in der Mitte des Textes vergisst (Lost-in-the-Middle-Phänomen). iRoPE verschränkt Rotationsfrequenzen über modulare Perioden und stellt sicher, dass Positionsabstände über Millionen von Tokens mathematisch eindeutig und scharf differenzierbar bleiben.
Die praktische Konsequenz dieser Architektur ist spektakulär: In quantisierter Form (FP8 oder AWQ 4-Bit) lässt sich Llama 4 Scout auf einer einzigen NVIDIA H100 GPU (80 GB VRAM) oder zwei NVIDIA L40S Beschleunigern hosten. Für Unternehmen bedeutet dies das Ende komplexer Vektordatenbank-Fragmentierungen für statische Wissensbestände. Statt ein 5.000-seitiges technisches Handbuch aufwendig in kleine Chunks zu zerlegen, semantisch zu indexieren und per Ähnlichkeitssuche unvollständig abzufragen, wird das gesamte Archiv direkt als Prompt übergeben. In Nadel-im-Heuhaufen-Tests (Needle-in-a-Haystack) erzielt Scout über das gesamte 10-Millionen-Fenster eine Wiederfindungsrate von über 99,4 %.
Experten-Tipp: KV-Cache Paging für 10M Tokens
Wer Llama 4 Scout mit vollem Kontextfenster betreibt, muss den KV-Cache zwingend über vLLMs PagedAttention mit FP8-Cache-Quantisierung konfigurieren (--kv-cache-dtype fp8). Ohne Paging und Quantisierung würde der KV-Cache für 10 Millionen Tokens allein mehr als 120 GB VRAM belegen – weit mehr als der eigentliche Modell-Footprint!
4. Deep Dive Maverick: 128 Experten, native Multimodalität & Agentic Coding
Während Scout auf maximale Durchsatzgeschwindigkeit und Textvolumen optimiert ist, stellt Llama 4 Maverick das intellektuelle Schwergewicht für komplexe logische Aufgabenstellungen dar. Mit insgesamt 400 Milliarden Parametern ist Maverick das größte Modell, das Meta uneingeschränkt als Open Weights zur Verfügung stellt. Das architektonische Meisterstück: Trotz der gewaltigen 400B-Kapazität beträgt die aktive Rechenlast pro Token exakt wie bei Scout lediglich 17 Milliarden Parameter.
Erreicht wird dies durch eine hochgranulare Aufteilung in 128 Experten-Netzwerke (Fine-Grained MoE). Während frühere MoE-Modelle wie Mixtral auf 8 Experten setzten, ermöglicht die feinteilige Zerlegung in 128 Experten eine unvergleichliche Spezialisierung der Gewichte:
1. Autonomes Software-Engineering
Spezialisierte Experten für Syntax-Validierung, Refactoring, Test-Driven-Development und statische Code-Analyse über mehr als 40 Programmiersprachen hinweg.
2. Multimodale CAD- & Bauplan-Diagnose
Native Bildverarbeitung von Schaltplänen, R&I-Fließbildern und technischen Zeichnungen ohne externe OCR- oder Vision-Pipelines.
3. Formale Logik & Regulatorik-Audits
Präzise Prüfung komplexer Vertragswerke, DSGVO-Verfahrensverzeichnisse und NIS-2-Konformitätsrichtlinien ohne Halluzinationen.
4. Autonome Tool-Use & MCP-Orchestrierung
Strikte JSON-Schema-Treue und robuste Ausführung mehrstufiger Agenten-Workflows über das Model Context Protocol (MCP) und OpenAPI-Schnittstellen.
5. Mathematische Optimierung & Kalkulation
Expertencluster für Finanzmathematik, Kostenrechnung und Supply-Chain-Engpassanalysen mit interner Verifikationsschleife.
Maverick verfügt über ein natives Kontextfenster von 1 Million Tokens und unterstützt native Multimodalität über ein Early-Fusion-Verfahren. Im Gegensatz zu traditionellen Ansätzen, bei denen visuelle Merkmale von einem separaten Vision-Encoder (wie CLIP) extrahiert und als Präfix an das Sprachmodell übergeben werden, operiert Maverick von Grund auf in einem gemeinsamen Vektorraum für Bild- und Text-Patches. Das Modell „sieht“ Schaltpläne, UI-Screenshots und Prozessdiagramme mit derselben semantischen Tiefe wie Quellcode.
Für agentische Arbeitsweisen ist Maverick ein Gamechanger. Bei anspruchsvollen Benchmarks wie SWE-bench Verified erzielt Maverick eine Lösungsquote von 72,6 % und deklassiert damit viele proprietäre Frontier-Modelle. In Kombination mit lokalen Entwicklungsumgebungen agiert Maverick als vollwertiger autonomer Pair-Programmer, der Tickets aus Jira liest, Codebases analysiert, Fehler behebt und automatisierte Tests durchführt – ohne dass geschäftskritischer Quellcode ein ausländisches Rechenzentrum verlässt.
5. Deep Dive Behemoth: Das 2-Billionen-Frontier-Modell als Wissens-Destillations-Motor
Mit Llama 4 Behemoth demonstriert Meta, was geschieht, wenn MoE-Architekturen in extreme Dimensionen skaliert werden. Mit schätzungsweise 2 Billionen Parametern (2.000 Milliarden) und 288 Milliarden aktiven Parametern pro Token ist Behemoth das rechenintensivste KI-Modell, das Meta jemals trainiert hat. Anders als Scout und Maverick ist Behemoth aufgrund seiner schieren Größe nicht für den typischen lokalen Mittelstandsbetrieb konzipiert – ein Cluster aus mindestens 32 bis 64 H100-GPUs wäre allein für das Laden der Gewichte erforderlich.
Warum ist Behemoth dennoch für Unternehmen von unschätzbarem Wert? Behemoth dient als technologischer Katalysator im gesamten Open-Weights-Ökosystem:
Behemoth löst hochkomplexe wissenschaftliche Probleme, formuliert rigorose mathematische Beweisketten und validiert komplexe Software-Architekturen. Diese Ausgaben fließen als hochreines Trainingsmaterial zurück in die Feinabstimmung kleinerer Modelle.
Die logischen Verknüpfungen und Argumentationsmuster von Behemoth wurden über Knowledge Distillation in die 17B-Aktivkerne von Scout und Maverick komprimiert. Dadurch weisen die kleineren Modelle eine Denk- und Problemlösungskompetenz auf, die für ihre Inferenzgröße bisher unvorstellbar war.
Unternehmen, die über Cloud-APIs Zugriff auf Behemoth erhalten, nutzen das Modell als unbestechlichen Richter zur kontinuierlichen Qualitätsprüfung und Regressionstestung ihrer internen On-Premise-Modelle.
Durch die Existenz von Behemoth beweist Meta, dass Open-Source-basierte Entwicklung nicht mehr der geschlossenen Forschung von OpenAI, Google oder Anthropic hinterherhinkt, sondern auf Augenhöhe agiert. Das aus Behemoth destillierte Wissen demokratisiert den Zugang zu Spitzenintelligenz für jedes europäische Unternehmen.
6. Benchmark-Härtetest: Llama 4 im direkten Leistungsvergleich
Um die Leistungsfähigkeit der Llama-4-Modelle objektiv einzuordnen, müssen sie sich an den anspruchsvollsten Branchen-Benchmarks messen lassen. Wir vergleichen Llama 4 Scout, Maverick und Behemoth mit den derzeit führenden Closed-Source- und Open-Source-Systemen: Claude 3.7 Sonnet, DeepSeek-V3 und GPT-4.5.
Die Messwerte belegen eine historische Verschiebung: Während Llama 4 Scout bei reinen Programmieraufgaben mit 64,2 % fast das Niveau von Claude 3.7 Sonnet erreicht – und das bei einem Bruchteil der Inferenzkosten –, zieht Maverick mit 72,6 % deutlich an bisherigen Spitzenreitern vorbei. Noch frappierender ist das Bild bei extremen Kontextlängen: Während proprietäre Modelle bei 200k bis 1M Tokens abriegeln oder mit massiven Latenzproblemen kämpfen, liefert Scout bei 10 Millionen Tokens eine nahezu perfekte Wiederfindungsrate von 99,4 %.
7. Enterprise-Architektur & Hardware-Sizing: VRAM-Kalkulation und vLLM-Hosting
Die betriebswirtschaftlich entscheidende Frage für jeden CIO und IT-Leiter lautet: Welche konkrete Hardware wird benötigt, um Llama 4 produktiv, performant und kosteneffizient im eigenen Unternehmen zu betreiben? Wer MoE-Modelle falsch dimensioniert, riskiert teure Fehlinvestitionen oder Systemabstürze durch VRAM-Überlauf (Out of Memory, OOM).
Kostenfalle 1: Unbedachte KV-Cache-Explosion bei Langkontext
Ein 10-Millionen-Token-Kontext erfordert selbst mit Interleaved Attention enormen dynamischen Speicher. Wer den KV-Cache nicht in FP8 quantisiert und unbegrenzten Concurrency-Traffic erlaubt, treibt selbst 8x H100 Server binnen Sekunden in den OOM-Crash.
Kostenfalle 2: Ineffizientes FP16-Weight-Hosting
Das Laden von Llama 4 Maverick (400B) in unkomprimiertem FP16 erfordert mindestens 800 GB reinen VRAM – das entspricht 10x H100 GPUs allein für die Modellgewichte. Moderner FP8-Betrieb senkt den Bedarf auf 400 GB und halbiert die Hardwarekosten bei identischer Genauigkeit.
Für den produktiven Einsatz im Jahr 2026 empfehlen wir auf Basis unserer Kundenprojekte zwei praxiserprobte Hardware-Szenarien:
Hardware-Dimensionierung: Scout vs. Maverick
- GPU-Bestückung: 1x bis 2x NVIDIA H100 NVL (80GB/94GB) oder 2x NVIDIA L40S (48GB)
- Quantisierung: FP8 Weights / FP8 KV-Cache (vLLM Engine)
- VRAM-Bedarf Gewichte: ~60 GB (FP8 quantisiert)
- Puffer für KV-Cache: ~25–35 GB für dynamischen Kontext bis 1M Tokens
- Investitionsrahmen: ca. 35.000 € bis 55.000 € On-Premise oder ~2,80 €/h Cloud-Miete
- Ideal für: KMU-Dokumentenanalyse, DSGVO-Supportbots, interne Codebase-Assistenten
- GPU-Bestückung: 8x NVIDIA H100 SXM5 (80GB) oder 4x NVIDIA H200 (141GB)
- Quantisierung: FP8 mit Tensor-Parallelismus (TP=8) via TensorRT-LLM / vLLM
- VRAM-Bedarf Gewichte: ~220 GB (FP8 quantisiert über Cluster verteilt)
- Puffer für KV-Cache: > 400 GB für parallele Langkontext-Sessions mehrerer Abteilungen
- Investitionsrahmen: ca. 240.000 € On-Premise oder ~18,00 €/h Colocation-Cluster
- Ideal für: Konzernweite Multi-Agenten-Automatisierung, F&E-Engineering, ERP-Kernprozesse
Ein entscheidender Vorteil moderner Inferenz-Engines wie vLLM oder SGLang ist die native Unterstützung von MoE-Offloading und PagedAttention. Da bei jedem Token-Durchlauf nur 17B Parameter berechnet werden, liegt der Stromverbrauch pro Token deutlich unter dem eines klassischen 70B-Dense-Modells. Die Gesamtkosten (TCO) pro Million generierter Tokens sinken im Vergleich zu Hyperscaler-APIs um bis zu 80 % bei einer jährlichen Auslastung von über 30 %.
8. Datenschutz & Compliance: DSGVO und EU AI Act ohne Hyperscaler-Risiko
Neben den betriebswirtschaftlichen und technischen Vorzügen ist die regulatorische Sicherheit der stärkste Treiber für den Einsatz von Llama 4 in Deutschland, Österreich und der Schweiz. Wer sensible Betriebsdaten, Patientendaten, Finanzströme oder patentrechtlich geschützte Entwicklungspläne verarbeitet, stößt bei US-amerikanischen Cloud-APIs unweigerlich an rechtliche Grenzen.
1. Vollständige DSGVO-Konformität (Art. 44 ff.)
Kein Datentransfer in unsichere Drittstaaten. Lokale Inferenz im firmeneigenen Netzwerk erfordert keine Standardvertragsklauseln (SCCs) und schließt unbefugte Datenzugriffe Dritter technisch aus.
2. Zero-Data-Retention & IP-Schutz
Firmeneigene Prompts, Konstruktionszeichnungen und Quelltexte werden weder zwischengespeichert noch für das Nachtrainieren externer Modelle verwendet. Geistiges Eigentum bleibt zu 100 % im Unternehmen.
3. Konformität mit dem EU AI Act
Llama 4 Open Weights ermöglichen lückenlose Transparenz, Auditierbarkeit von Modellgewichten und den Nachweis von Bias-Prüfungen gemäß den Anforderungen für Hochrisiko-KI-Systeme nach Annex III.
4. Unabhängigkeit von API-Deprecations
Open-Weights-Modelle können nicht von externen Anbietern abgeschaltet, im Verhalten unangekündigt verändert oder im Preis verdreifacht werden. Investitionssicherheit für unternehmenskritische Softwarearchitekturen.
Die Bereitstellung von Llama 4 unter der liberalen Llama 4 Community License erlaubt Unternehmen mit bis zu 700 Millionen monatlich aktiven Nutzern die uneingeschränkte kommerzielle Nutzung, Modifikation und lokale Ausführung. Für den europäischen Mittelstand bedeutet dies: Absolute Souveränität über die eigene generative Kerninfrastruktur.
9. Implementierungs-Roadmap: In 5 Phasen zum produktiven MoE-Stack
Der erfolgreiche Rollout von Llama 4 in einer heterogenen Unternehmens-IT erfordert eine strukturierte Vorgehensweise. Unser praxiserprobter 5-Phasen-Plan führt Organisationen risikofrei vom ersten Proof-of-Concept zur hochverfügbaren Produktivumgebung:
-
Phase 1: Use-Case-Scoping & Hardware-Audit (Woche 1–2)
Identifikation der priorisierten Geschäftsprozesse (z. B. 10M-Dokumenten-Audit vs. autonomes Agentic Coding). Analyse vorhandener Serverressourcen und Entscheidung über On-Premise-Beschaffung vs. souveränes Colocation-Hosting in zertifizierten DACH-Rechenzentren.
-
Phase 2: Inferenz-Containerisierung & Quantisierung (Woche 3–4)
Aufsetzen der produktiven Inferenz-Engine (vLLM oder SGLang) mit Docker und Kubernetes. Konvertierung und Validierung der Llama 4 Gewichte in FP8-Präzision. Benchmarking von Token-Durchsatz, Latenz und VRAM-Stabilität unter Volllast.
-
Phase 3: System-Integration via MCP & REST-Gateways (Woche 5–6)
Anbindung des Modells an interne Datenquellen (ERP, CRM, Git-Repositories, Confluence) über standardisierte Schnittstellen und das Model Context Protocol (MCP). Implementierung von Zero-Trust-Rollen- und Berechtigungskonzepten für Mitarbeiterabfragen.
-
Phase 4: Agenten-Orchestrierung & Guardrails (Woche 7–8)
Konfiguration domänenspezifischer Multi-Agenten-Pipelines mit Frameworks wie LangGraph oder AutoGen. Etablierung automatisierter Guardrails zur Validierung strukturierter JSON-Outputs und Verhinderung unerwünschter Verhaltensweisen.
-
Phase 5: Produktivbetrieb, Monitoring & Continuous Evaluation (Ab Woche 9)
Überwachung der Inferenzmetriken via Prometheus und Grafana (Tokens/s, Queue-Länge, Cache-Hit-Rate). Kontinuierliche Qualitätsprüfung der Modellausgaben über automatisierte Regressions-Suites und bedarfsgerechte LoRA-Feinabstimmungen.
10. Quick-Check & Fazit: Warum der Mittelstand jetzt auf Llama 4 setzen sollte
Metas Llama 4 Familie markiert das Ende des Glaubenskriegs zwischen Open-Source-Software und proprietären Cloud-Diensten. Mit Scout beweist Meta, dass extremes Langkontext-Verständnis über 10 Millionen Tokens auf einer einzigen Server-GPU Realität sein kann. Mit Maverick steht Unternehmen ein Werkzeug für autonomes Reasoning und agentisches Coding zur Verfügung, das geschlossenen Hyperscaler-Lösungen in nichts nachsteht – und mit Behemoth treibt ein forschungsstarkes Lehrermodell das gesamte Ökosystem kontinuierlich voran.
Für Entscheider im Mittelstand ist das Signal unmissverständlich: Wer jetzt auf Open-Weights-Architekturen wie Llama 4 setzt, sichert sich maximale Kosteneffizienz, vollständige DSGVO-Konformität und strategische Unabhängigkeit für die nächste Dekade generativer KI-Anwendungen.
Quick-Check: Ihr Einstieg in die Llama-4-Architektur
Haben Sie Fragen zur Llama 4 Architektur oder lokalen Bereitstellung?
Kostenlose Erstberatung vereinbarenUnsere Expertise vor Ort
Wir sind Ihr digitaler Partner – regional verankert und überregional erfolgreich.
Haben Sie eine Vision?
Lassen Sie uns gemeinsam prüfen, wie wir Ihre Idee zum Fliegen bringen.
Jetzt kostenloses Strategiegespräch buchenErweitertes Fachglossar
Mixture of Experts (MoE)
Eine modulare KI-Architektur, bei der dynamische Router-Netzwerke für jeden Token gezielt nur spezialisierte Teilnetzwerke (Experten) aktivieren, was enorme Modellkapazität bei minimalem Rechenaufwand erlaubt.
Active Parameters
Die Anzahl an Parametern, die pro Vorwärtslauf tatsächlich berechnet werden. Bei Llama 4 Scout und Maverick liegt dieser Wert bei lediglich 17 Milliarden Parametern.
Interleaved Attention
Kombination aus Sliding-Window- und globaler Attention, die den Speicherbedarf des KV-Caches minimiert und Sequenzen von bis zu 10 Millionen Tokens ermöglicht.
Knowledge Distillation
Verfahren zur Wissensübertragung von gigantischen Lehrermodellen (wie Behemoth mit 2T Parametern) auf schlanke, recheneffiziente Schülermodelle (Scout und Maverick).
iRoPE
Interleaved Rotary Position Embeddings zur mathematisch stabilen Kodierung relativer Token-Positionen über extreme Distanzen von mehreren Millionen Tokens.
Llama 4 Scout
Metas hocheffizientes Open-Weights-Modell mit 109B Gesamt- und 17B aktiven Parametern sowie 10M Token Kontextfenster für den Betrieb auf einer einzelnen H100-GPU.
Llama 4 Maverick
Metas 400B-Flaggschiff mit 128 Experten (17B aktiv) und 1M Token Kontext für anspruchsvolles multimodales Reasoning und agentenbasiertes Coding.
Sparse Routing
Entscheidungsmechanismus im Transformer-Block, der Eingabe-Tokens dynamisch den am besten geeigneten Experten zuweist.