Am 7. November 2026 habe ich mein erstes Werbevideo mit Gemini Omni 1.2 Flash gebaut: 49 Sekunden über unseren KI-Telefonassistenten, gesprochen von meinem eigenen Avatar. Bild und Stimme waren schnell gut. Gelernt habe ich vor allem etwas über die Länge der Takes, und das spart bares Geld.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: KI-Video-Fabrik: Videos mit Ihrem Avatar →
Das Projekt: 49 Sekunden über den Telefonassistenten
Seit dem 2. November 2026 nimmt ein KI-Telefonassistent die Anrufe auf der Firmennummer von Pragma Code an. Dazu wollte ich ein kurzes Hochformat-Video für LinkedIn und den WhatsApp-Status: ich selbst als Avatar, ein paar Zwischenbilder, Untertitel, am Ende die Nummer zum Ausprobieren. Gebaut habe ich es in Google Flow mit Gemini Omni 1.2 Flash, das dort seit dem 5. November 2026 verfügbar ist. Geschnitten wurde in Remotion.
Das Ergebnis: vier Avatar-Takes, zwei Zwischenbilder ohne Avatar, zusammen 49 Sekunden.
Bild und Stimme: besser als bei Omni 1.1
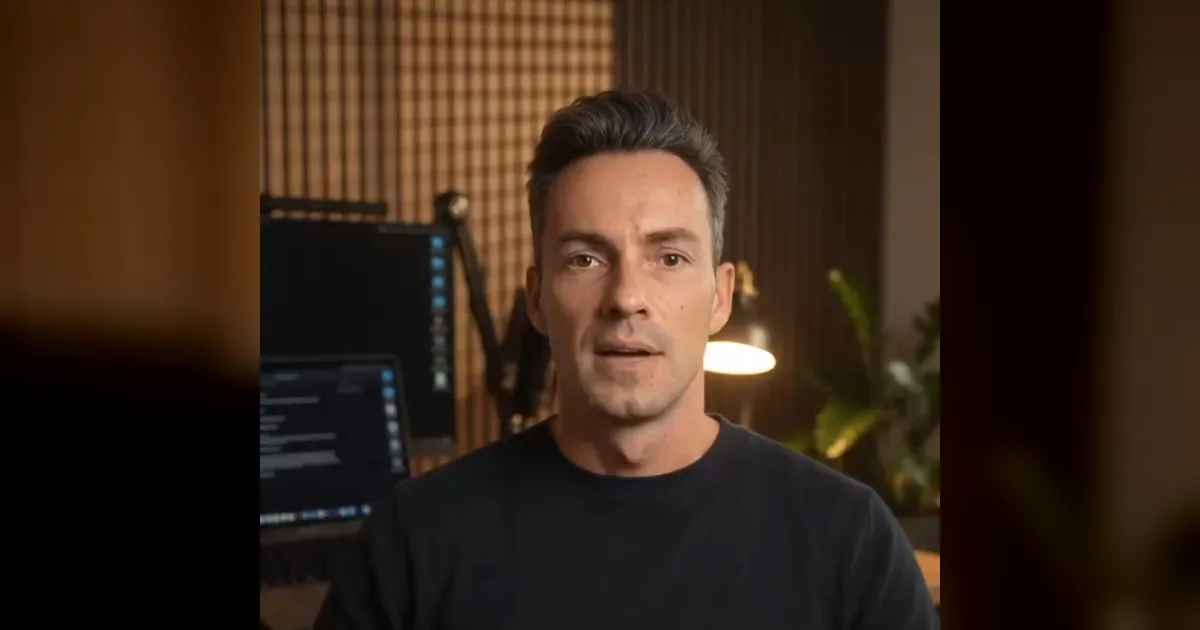
Mimik, Bildqualität und die Ähnlichkeit der Stimme fand ich sehr gut, besser als bei Omni 1.1. Alle Avatar-Takes starten vom selben Startbild: mein Büro am Abend, schwarzer Pullover, warmes Licht. Omni 1.2 hat Raum, Kleidung und Licht über alle Takes gehalten. Abwechslung kam deshalb nicht aus dem Avatar, sondern aus den Zwischenbildern und aus unterschiedlichen Bildausschnitten im Schnitt.
Zwei technische Details für die Planung: Flow liefert 24 Bilder pro Sekunde. Avatar-Takes ließen sich in 1080p herunterladen, die Zwischenbilder ohne Avatar nur in 720p. Für Einschübe von zwei bis vier Sekunden reicht das.
Zu lange Takes: Das Modell erfindet Text
Meine ersten beiden Takes habe ich auf 15 Sekunden gestellt und viel Text hineingegeben. Das ging schief, auf zwei verschiedene Arten:
- Take 1, 33 Wörter: Der Text war nach 10,8 Sekunden gesprochen. Danach 1,3 Sekunden Stille, dann ein Satz, der nicht im Skript stand, inklusive Versprecher („bares Geld, bares Geld“).
- Take 2, 40 Wörter: Fertig nach 11,0 Sekunden. Dafür fehlten zehn Wörter mitten im Text, und der letzte Satz kam zweimal.
Mein Eindruck: Omni 1.2 plant pro Take nur etwa elf Sekunden Sprechzeit ein, egal wie lang der Take eingestellt ist. Zu viel Text wird gekürzt, übrige Zeit wird aufgefüllt. Das ist ein Befund aus zwei Takes, Google hat es nicht bestätigt. Verstärkt hat es vermutlich meine Anweisung, der Avatar solle „bis zum letzten Bild sprechen“. Die habe ich gestrichen. Seitdem steht in der Anweisung: Text genau einmal sprechen, danach ruhig in die Kamera schauen.
Den erfundenen Satz habe ich übrigens behalten. „Da geht Ihnen doch bares Geld verloren“ passte inhaltlich, nur die Wiederholung musste raus.
Sprechtempo: knapp drei Wörter pro Sekunde
Gemessen habe ich 2,7 bis 3,1 Wörter pro Sekunde. Lange Wörter fressen Zeit: „KI-Telefonassistenten ein“ allein dauerte etwa 1,4 Sekunden. Mit 12-Sekunden-Takes und weniger Text lief es dann sauber:
- 29 Wörter: gesprochen in 10,1 Sekunden
- 28 Wörter: gesprochen in 7,6 Sekunden
Danach lächelte der Avatar ruhig in die Kamera, ohne Wiederholung. Die Pause schneide ich im Schnitt ohnehin weg.
Was die Sekunden kosten
Flow rechnet in Credits ab. Bei 720p kostet jede Sekunde bis Sekunde 10 drei Credits, ab Sekunde 11 das Doppelte, also sechs. Das deckt sich mit der Hilfe-Seite von Flow und mit dem, was mir abgezogen wurde:
- 10 Sekunden: 30 Credits
- 12 Sekunden: 42 Credits
- 15 Sekunden: 60 Credits
Ein 15-Sekunden-Take kostet also doppelt so viel wie einer mit 10 Sekunden. In meinen ersten beiden Tests brachten die zusätzlichen Sekunden nur Füllmaterial.
Meine Regel: 10 Sekunden, 22 bis 26 Wörter
Daraus ist eine einfache Regel geworden: Takes von 10 Sekunden mit 22 bis 26 Wörtern. Das ist die günstigste Stufe, der Text passt hinein, und ein kurzer Rest wird geschnitten. Der Flow-Agent schlug übrigens von sich aus 10 statt 12 Sekunden vor. Der zuletzt erzeugte Take (Notiz und Festpreis) hatte 25 Wörter bei 10 Sekunden. Zahlen im Sprechtext schreibe ich aus („vierzehnhundertneunzig“), damit der Avatar sie richtig ausspricht.
Versprecher schneiden: Wort-Zeitstempel reichen nicht
Für den doppelten Versprecher wollte ich die Wort-Zeitstempel der Spracherkennung Whisper nutzen. Whisper glättet aber Wiederholungen: Aus „bares Geld, bares Geld“ wird im Transkript einmal „bares Geld“, und die Wortgrenzen stimmen an dieser Stelle nicht.
Funktioniert hat ein kleinteiligerer Weg: Lautstärke und Nulldurchgangsrate in 10-Millisekunden-Schritten auswerten (Zischlaute wie s, ch und f sieht man darin deutlich), mögliche Silben einzeln ausschneiden und einzeln transkribieren, Schnitte nur in echte Stille legen (leiser als −45 dB) und die neue Naht noch einmal transkribieren. Die Endkontrolle bleibt trotzdem beim Ohr.
Noch nicht getestet
Die Funktion „Verlängern“ (nur bei Omni 1.2) und die Avatare in Google Vids habe ich nicht ausprobiert. Dazu kann ich noch nichts sagen.
Fazit
Omni 1.2 sieht gut aus und klingt nach mir. Das Geld entscheidet sich bei der Länge: kurze Takes, genau passender Text, eine Anweisung, die das Modell nicht zum Auffüllen drängt. Wer solche Videos regelmäßig braucht, ohne sich selbst um Takes und Schnitt zu kümmern, findet das fertige System in der KI-Video-Fabrik. Und wer den Assistenten aus dem Video ausprobieren will: KI-Telefonassistent, Nummer steht auf der Seite.
Videos mit Ihrem eigenen Avatar
Ich baue Ihnen das System, mit dem solche Videos regelmäßig entstehen: Avatar, Stimme, Sprechtexte und Schnitt.
Zur KI-Video-FabrikErweitertes Fachglossar
Take
Ein einzelner generierter Videoclip in Google Flow. Seine Länge wird vor dem Erzeugen eingestellt und bestimmt die Kosten in Credits.
Startbild
Das erste Bild eines Takes, das Flow vorgegeben bekommt. Es legt Raum, Kleidung, Licht und Bildausschnitt fest.