Ob der interne Assistent spontan antwortet oder bei Teamlast ins Stocken gerät, entscheidet der gesamte Inferenzpfad. So prüfen KMU Engine, Modell und Hardware mit denselben Anfragen.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: KI & Automatisierung →
Welche Inferenz-Engine passt zu Ihrem KMU?
Der Prototyp beantwortet eine Frage auf dem Mac Studio zügig. Sobald das Team gleichzeitig mehrere lange Dokumentanfragen stellt, muss derselbe Dienst Texte verarbeiten, bereits laufende Antworten weitergenerieren und neue Anfragen einplanen. Die Wartezeit, die dabei entsteht, sieht man in einem Einzeltest kaum. Für die Auswahl einer Engine lohnt es sich deshalb, den Arbeitsplatz und den gemeinsam genutzten Dienst als zwei verschiedene Einsatzfälle zu testen.
Für einen ersten Pilot lässt sich Ollama einfach in einen lokalen Arbeitsablauf einbinden. llama.cpp ist interessant, wenn Sie Modellartefakt, Backend und Offload gezielt einstellen wollen. vLLM gehört in die engere Wahl für einen gemeinsam genutzten CUDA-Endpunkt. Ob die Konfiguration trägt, entscheidet der Vergleich mit Ihren tatsächlichen Längen, Zugriffsmustern und Qualitätsanforderungen. Ein Supportteam mit kurzen Rückfragen stellt andere Ansprüche als eine Anwendung, die umfangreiche Handbücher in den Kontext holt.
Das Wichtigste für die Entscheidung
- Antwortbeginn. Die Time to First Token (TTFT) am Client messen. So geht die Wartezeit im Gateway und in der Engine in den Vergleich ein.
- Teamlast. Ausgabetokens pro Sekunde zusammen mit Fehlerquote und einem vorab vereinbarten Latenzziel bewerten.
- Speicherreserve. Die längsten gleichzeitig residenten Kontexte einschließlich bereits erzeugter Tokens und den Betriebsbedarf einplanen.
AI Context 2026 – KI-Souveränität und Inferenzkosten
Die Release-Notizen zu vLLM v0.34.0 dokumentieren den standardmäßig erweiterbaren KV-Cache auf CUDA und ROCm. Der Cache wird anhand des nach dem Warm-up verfügbaren Speichers dimensioniert. In der Ollama-Release-Übersicht ist v0.40.16 als stabiler Stand geführt. Unter v0.40.17 ist der Vorab-Tag v0.40.17-rc4 mit angekündigter paralleler Verarbeitung auf Apple Silicon gelistet. llama.cpp b12590 ist als Vorabstand markiert und führt macOS-Builds. Für Apple ist vLLM Metal eine eigenständige Plugin-Konfiguration. Legen Sie Plugin-Version, Modell und Feature-Abdeckung separat fest. Diese Release-Angaben beschreiben Funktionen und dienen der Einordnung des Testaufbaus.
Für den Kostenvergleich teilen Sie anteilige Hardware-, Strom- und Betriebskosten durch die Zahl erfolgreich bedienter Anfragen im selben Zeitraum. Messen Sie dafür Energie am Gerät, auch während Leerlauf und Modellwechseln, und rechnen Sie Wartungszeit mit ein. Klären Sie im Rahmen Ihrer Strategie für digitale Souveränität, wohin Prompts, Dokumente, Antworten und Protokolle gelangen und welche Verbindungen für Modellbezug, Updates und Telemetrie bestehen.
vLLM vs. Ollama vs. llama.cpp im Benchmark
Dieses Warmstart-Referenzszenario vergleicht vLLM, Ollama und llama.cpp auf einer NVIDIA GeForce RTX 4090 mit 24 GB VRAM unter Linux mit CUDA 12.4. Alle drei Konfigurationen verwenden Meta Llama 3.1 8B Instruct bei einem Kontextlimit von 4.096 Tokens. vLLM nutzt AWQ 4-Bit, Ollama und llama.cpp nutzen GGUF Q4_K_M.
Datenbasis sind die redaktionell bereitgestellten Messwerte für diesen Aufbau. Rohprotokolle, Engine-Versionen und konkrete SLO-Grenzwerte liegen zur unabhängigen Prüfung nicht vor.
Vergleichbare Tests aufsetzen
Führen Sie auf jeder NVIDIA-Karte eine eigene Linux/CUDA-Reihe durch. Unter macOS protokollieren Sie Chip, Unified Memory, Systemversion und Backend. Halten Sie außerdem Treiber, Release und Commit der Engine, Startparameter, GPU-Takt, Temperatur und Auslastung fest. Der Lastclient muss genug Reserven haben, um das geplante Anfragemuster einzuhalten. Platzieren Sie ihn für jeden Vergleich an derselben Stelle im Netzwerk und halten Sie Stream-Protokoll und Verbindungswiederverwendung konstant.
Llama 3.1 und DeepSeek als getrennte Testreihen
Als Primärmodell eignet sich Metas Llama 3 in der Variante Llama 3.1 8B Instruct. Pinnen Sie Revision und SHA-256 des Artefakts, Tokenizer, Chat-Template, Kontextbudget, Ausgabegrenze, Sampling und Stop-Regeln. Prüfen Sie vorab mit einem kurzen Aufruf, ob derselbe Prompt wirklich als dieselbe Tokenfolge ankommt. Ein gleichnamiges Modell in zwei Katalogen kann andere Gewichte, Vorlagen oder Standardparameter mitbringen. Im kontrollierten Lauf gehören dieselbe Gewichtsdatei und derselbe KV-Datentyp in alle unterstützten Setups. Wo ein gemeinsames Format fehlt, dokumentieren Sie die Teilmenge oder vergleichen Sie explizit vollständige Produktionskonfigurationen samt Quantisierung.
Führen Sie DeepSeek-R1-Distill-Llama-8B als eigene Reihe. DeepSeek-AI veröffentlicht Destillate und vollständige R1-Modelle als getrennte Checkpoints. Protokollieren Sie bei Reasoning-Modellen den ersten generierten Inhalt und den Beginn der sichtbaren Antwort getrennt, wenn die API Denk- und Antwortkanal separat anbietet. Definieren Sie, welche Tokens in den Durchsatz eingehen. Legen Sie für kurze Chats und lokales Enterprise RAG längere, synthetische Dokumentprompts aus einem versionierten Korpus bereit. Feste Aufgaben mit erwarteten Fundstellen erleichtern die Qualitätsprüfung.
Warmstart, Kaltstart und Lastprofil
Starten Sie mit warmen Einzelanfragen. Lassen Sie Modellladung und Initialisierung vor dem Messfenster abschließen und halten Sie Kaltstarts separat fest. Wählen Sie im Basislauf unterschiedliche Präfixe. Prüfen Sie wiederholte Präfixe gezielt in einer weiteren Reihe. Als geplante Laborstufen bieten sich ein, zwei, vier und acht gleichzeitig offene Streams an, soweit die Hardware sie trägt. Ergänzen Sie offene Ankunftsraten: Ein Client, der erst nach Abschluss einer Antwort neue Last erzeugt, verdeckt einen Teil der Warteschlangendynamik.
Erfassen Sie nach dem Warm-up je Stufe mindestens drei unabhängige Messfenster als Stichprobenregel. Veröffentlichen Sie Stichprobengröße, Perzentilmethode, Messdauer, Aufwärmphase und Abbrüche. Stempeln Sie mit einer monotonen Uhr den Versand und das erste generierte Token. Bei SSE- oder JSONL-Adaptern ignorieren Sie leere Chunks, Rollenmarker und Metadaten. Ist nur ein erstes Textfragment erkennbar, benennen Sie es als TTFT-Proxy. Nutzen Sie verifizierte Engine-Zähler oder einen fest vereinbarten Tokenizer für die Ausgabetokens und dokumentieren Sie bekannte Abweichungen.
Protokollieren Sie pro Messfenster auch die tatsächlich erreichte Ankunftsrate. Wenn der Client aufgrund eigener Limits hinter dem Lastplan zurückbleibt, ist ein unauffälliger p95-Wert wenig aussagekräftig. Prüfen Sie während einer Spitze außerdem, ob ein Verbindungsabbruch die Generierung am Server beendet. Andernfalls verbrauchen bereits verlassene Anfragen weiterhin Rechenzeit und Kontextspeicher.
vLLM-Durchsatz für KMU unter Last
Für KMU mit einem gemeinsam genutzten Assistenten liefert vLLM in diesem Szenario den höchsten Gesamtdurchsatz und beansprucht den meisten Grafikspeicher. llama.cpp liegt bei beiden Kennzahlen dazwischen. Ollama belegt am wenigsten Speicher, verarbeitet die Anfragen hier aber nacheinander. Für die Planung zählen deshalb auch die Wartezeit pro Anfrage und die GPU-Reserve für andere Dienste.
Ein Service Level Objective (SLO) legt vorab fest, welche Latenzen und Fehlerraten das Team akzeptiert. Beim Lasttest zählt jede angebotene Anfrage für die Erfolgsquote, auch Timeouts, abgebrochene Streams und Speicherfehler. Goodput bezeichnet hier die Zahl der Anfragen pro Sekunde, die das definierte Ziel erfüllen. Summierte Ausgabetokens pro Sekunde beschreiben dagegen die Gesamtarbeit. Prüfen Sie zusätzlich Zeit bis zur vollständigen Antwort und den Abstand zwischen Textfragmenten. Eine volle GPU kann bei langen Prompts viel Arbeit leisten, während eine Warteschlange kurze Dialoge verzögert.
vllm bench serve und der llama.cpp Server Benchmark helfen bei der Gegenprobe auf dem jeweiligen Stack. Die Generate API liefert mit eval_count / eval_duration × 10⁹ einen internen Diagnosewert für den Decode, weil Ollama die Dauer in Nanosekunden liefert. llama-bench trennt unter anderem Promptverarbeitung und Tokengenerierung. Für den Dreiervergleich zählt das gemeinsame Client-Protokoll. Sichern Sie pro Messpunkt Hardware-ID, Datenrevision, Artefakt und Pipeline-Konfiguration zusammen mit den Rohdaten. So bleibt ein Wiederholungslauf möglich, wenn eine Engine ihre Standardwerte ändert.
Setzen Sie vorab eine Mindestanforderung an die Antwortqualität und bestimmen Sie, welche Antworten in die Abnahme eingehen. Bei einem internen Suchassistenten kann eine syntaktisch gültige Antwort fachlich wertlos sein, wenn ihr Beleg aus dem falschen Handbuch stammt. Prüfen Sie deshalb die Fehlerarten neben den Laufzeitmetriken. Ein SLO-konformer Stream ersetzt diese Qualitätsprüfung nicht.
Wie lokale Inferenz-Engines Anfragen verarbeiten
Ein lokaler Assistent besteht aus mehreren Schichten. Die Anwendung baut den Prompt, das Gateway nimmt Anfragen an, und die Engine verwaltet aktive Sequenzen und erzeugt Tokens. Der Modellserver verarbeitet den Eingabekontext im Prefill und erzeugt danach im Decode weitere Tokens. Eingabelänge und Antwortbudget wirken damit auf verschiedene Abschnitte desselben Datenpfads. Die Abbildung zeigt, welche Komponenten an den Phasen beteiligt sind und wo die Plattform den Speicher bereitstellt.
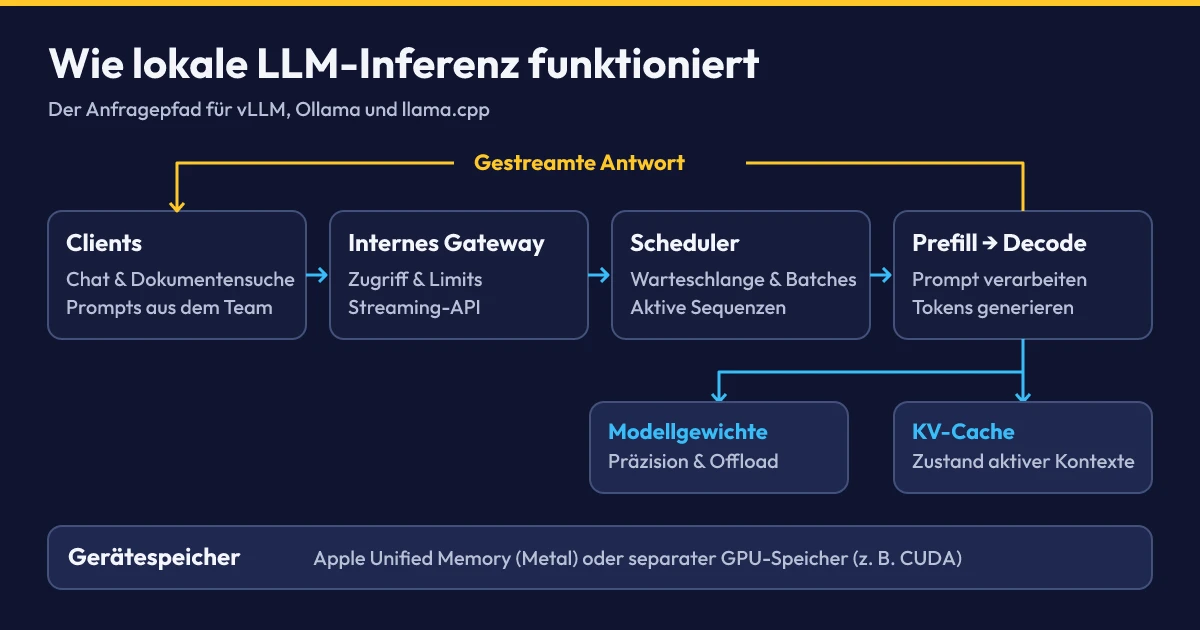
Vier Bausteine einer Inferenz-Architektur
Anfrageannahme und API
Ein internes Gateway prüft die Identität, beschränkt Nutzlast und Parallelität je Client und reicht Anfragen samt Abbruchsignal weiter. Ein gemeinsamer API-Stil erleichtert Integration und Messung. Prüfen Sie dennoch das verwendete Template, die Bedeutung von Usage-Feldern, Fehlerstatus und Tool-Aufrufen pro Engine. Wenn der Proxy Stream-Fragmente puffert, misst der Nutzer die Verzögerung dieses Puffers mit. RAG-Dokumente brauchen ihre Zugriffsprüfung bereits bei der Suche. Der Modellserver erhält nur die freigegebenen Ausschnitte und den dafür nötigen Kontext.
Continuous Batching und PagedAttention
Continuous Batching legt fest, welche Anfragen sich einen Rechenschritt teilen. Fertige Sequenzen geben Kapazität frei, neu zugelassene können in folgende Schritte aufgenommen werden. PagedAttention verwaltet die Schlüssel- und Wertzustände für Attention blockweise. Die PagedAttention-Publikation von Kwon et al. beschreibt, wie das die Fragmentierung begrenzen kann. llama.cpp dokumentiert parallele Slots und Continuous Batching in der Serverdokumentation. Welche Sequenzen unter Last tatsächlich gleichzeitig laufen, hängt bei Ollama vom Runner, den Limits und dem verfügbaren Speicher ab. Messen Sie deshalb auch, wann Anfragen warten oder abgewiesen werden.
llama.cpp, GGUF und VRAM
GGUF ist ein Container für Gewichte und Metadaten mit Unterstützung für unterschiedliche Darstellungen. Der KV-Cache speichert die bei der Attention wiederverwendeten Schlüssel und Werte. Sein Datentyp ist eine eigene Einstellung. Berechnen Sie für Standard-MHA oder GQA die Nutzlast aus den tatsächlich residenten Tokens und halten Sie Blockrundung und geteilte Präfixe separat fest. Bei einer reservierten Poolgröße geht der Pool einmal ins Gerätebudget ein. Ausgelagerte Daten entlasten das Gerät und brauchen Host-RAM. Messen Sie den Einfluss von Offload auf Antwortbeginn und Speicherbandbreite.
Multi-GPU- und Cluster-Skalierung
Tensorparallelismus teilt Tensoroperationen innerhalb von Schichten. Pipeline-Parallelismus verteilt Schichten auf Geräte. Beide können Modelle unterbringen, deren Speicherbedarf die Einzelkarte übersteigt. Replikate halten eigenständige Modellkopien und können Anfragen unabhängig bedienen. Welche Variante besser zur Aufgabe passt, hängt von Modellgröße, Last und Topologie ab. Erfassen Sie die Verbindung zwischen den Karten und rechnen Sie je Gerät: Schichten, KV-Heads und temporäre Puffer müssen sich nicht gleichmäßig verteilen. Die vLLM-Dokumentation zur Skalierung erläutert mögliche Konfigurationen.
Experten-Tipp – GGUF, AWQ oder GPTQ wählen
Beginnen Sie mit GGUF, wenn Sie Metal oder gezielten CPU/GPU-Offload brauchen und das konkrete Modell unterstützt wird. Für vLLM mit CUDA können AWQ oder GPTQ sinnvoll sein, wenn GPU, Kernel und Checkpoint zusammenpassen. Prüfen Sie die vLLM-Quantisierungsmatrix und die separate GGUF-Dokumentation für vLLM für Ihre Version. Kontrollieren Sie am selben freigegebenen Aufgabenbestand auch Quellenbezug, strukturierte Ausgabe und fachliche Treffer. Verwenden Sie bei einem Wechsel der Gewichtsrepräsentation Ihren Qualitätsbefund neben den Leistungswerten. So lässt sich ein schnelleres Setup aussortieren, dessen Ausgaben häufiger nachbearbeitet werden müssen.
Lesen Sie bei der Artefaktfreigabe auch die Modelllizenz und halten Sie fest, wer eine Datei konvertiert hat. Speichern Sie die Vorlagen und die Konvertierungsparameter mit dem Prüflauf. Bei einer späteren Aktualisierung können Sie so Modelländerungen von den Folgen eines neuen Kernels oder eines anderen Cache-Datentyps unterscheiden.
Von der Entwicklungsumgebung zum On-Premise-Server
Im Pilot können Modell und Anwendung auf derselben Maschine laufen. Im Dienstbetrieb kommen Netzwerk, Berechtigungen, Betriebsüberwachung und ein Wiederanlauf nach Fehlern hinzu. Wer diese Pfade schon in der Pilotmessung berücksichtigt, kann die gewonnenen Ergebnisse später mit den Produktionsdaten vergleichen.
Solo-Tests und Produktionsbetrieb im Vergleich
Entwickler-Testing und Einzelanfragen
Halten Sie auf dem Mac Studio ein festes Prompt-Set, den Modellhash und die Runner-Einstellungen bereit. Prüfen Sie Antwortbeginn, Stream-Verhalten und Aufgabenqualität nach dem Modellwechsel erneut. Nehmen Sie einige lange Eingaben dazu, damit eine schnelle Kurzantwort keinen überlasteten Dokumentpfad verdeckt.
Produktions-Server und gleichzeitige Anfragen
Legen Sie Queue-Grenze, Zeitüberschreitung und einen kontrollierten Überlaststatus fest. Beobachten Sie p95-TTFT, Fehler, aktive Kontexte und freie Kapazität am gemeinsamen Endpunkt. Testen Sie die Rückkehr zur normalen Last nach einer Spitze. Ein health check sollte auch erkennen, ob der Dienst tatsächlich ein Modell bedienen kann.
Hardwarewahl für Mac Studio, RTX 4090 und RTX A6000
Mac Studio. Bei Apples Mac Studio teilen sich CPU, GPU, Betriebssystem und Anwendungen Unified Memory. Protokollieren Sie den konkreten Ausbau, die im Betrieb freie Kapazität, Speicherdruck und Swap. Auf dem Mac ist die Messung ein eigenes Profil: Mit Metal, gegebenenfalls einem anderen Backend und separaten Speicherzählern lässt sie sich innerhalb der Plattform vergleichen.
RTX 4090 und RTX A6000. NVIDIA spezifiziert für die GeForce RTX 4090 24 GB und für die RTX A6000 48 GB. Messen Sie den verfügbaren Speicher in GiB mit dem eingesetzten Treiber. Für Llama 3.1 8B ist auf beiden Karten ein Probelauf mit passender Quantisierung naheliegend. Das optionale 70B-Profil verlangt eine separate Kalkulation: Idealisiert brauchen 70 Milliarden Parameter bei vier Bit bereits rund 32,6 GiB reine Gewichte. Das übersteigt die 4090-Kapazität. Auf der A6000 müssen zusätzlich Cache, Workspaces und Reserve in den gemessenen freien Speicher passen. Die Modellklassen stammen aus der Llama 3.1 Model Card von Meta. Wenn die Rechnung eng ausfällt, testen Sie einen kürzeren Kontext, Offload oder Modellteilung als eigene Konfigurationen.
Gewichte [Byte] ≈ Parameter × effektive Bits je Gewicht / 8KV-Nutzlast [Byte] ≈ residente Tokens × KV-Layer × KV-Heads × Head-Dimension × (Byte je K-Element + Byte je V-Element)
Rechenbeispiel für die VRAM-Planung. Bei idealisierten acht Milliarden Parametern und vier Bit ergeben sich 8.000.000.000 × 4 / 8 = 4.000.000.000 Byte ≈ 3,73 GiB reine Gewichte. Der KV-Anteil beträgt bei getrennt angenommenen 4.096 residenten Tokens, 32 Layern, acht KV-Heads, Head-Dimension 128 und je zwei Byte für K und V 4.096 × 32 × 8 × 128 × (2 + 2) = 536.870.912 Byte = 512 MiB. Das sind hypothetische Annahmen. Teilen Sie Byte durch 2³⁰ für GiB. Addieren Sie im Gerätebudget residente Gewichte, den reservierten KV-Pool, Workspaces, Runtime und Treiber sowie die Betriebsreserve. Prüfen Sie am realen Artefakt Metadaten und gemischte Präzision. Siehe Metas Leitfaden zum Inferenzspeicher und PagedAttention-Publikation.
Ollama im Produktionsbetrieb
Binden Sie den Ollama-Endpunkt privat und authentifizieren Sie Zugriffe am Gateway. Prüfen Sie, welcher Runner das lokale Modell ausführt, welchen Speicher parallele Kontexte beanspruchen und wie sich Queue, Modellwechsel und Abbruch verhalten. Die Local FAQ dokumentiert die Stellgrößen. Testen Sie mit der freigegebenen Modellkopie auch einen Neustart ohne Registry-Zugriff. Zum On-Premise-Betrieb im DACH-Raum gehören kontrollierte Updates und klare Zuständigkeiten zum Datenpfad.
Für den Alltag zählt auch der Zustand zwischen zwei Lastspitzen. Bleibt das Modell geladen, sind die nächste Antwort und der belegte Speicher anders zu bewerten als nach dem Entladen. Wenn mehrere Prozesse denselben Rechner nutzen, testen Sie das Profil mit dieser Hintergrundlast. Legen Sie fest, welche Fehler einen Rückfall auf einen zweiten Endpunkt auslösen und welche Anfragen Clients wiederholen dürfen. Erfassen Sie im Monitoring nur die Metadaten, die Sie für diese Entscheidungen brauchen. Prüfen Sie bei externen Beteiligten insbesondere Auftragsverarbeitung und mögliche Drittlandtransfers nach Art. 28 und Kapitel V der DSGVO.
Vom Benchmark zur produktiven Einführung
Last und Datenflüsse erfassen
Erfassen Sie Datenklassen, Promptgrößen, Lastspitzen und Latenzziele. Berücksichtigen Sie Prompts, Dokumente, Ausgaben und Kopien in Logs oder Backups.
Modelle und Hardware vorprüfen
Pinnen Sie die Artefakte, rechnen Sie das Budget für gleichzeitig aktive Kontexte durch und definieren Sie repräsentative Qualitätsfälle.
Endpunkte unter Last vergleichen
Messen Sie warme, kalte und überlastete Zustände. Legen Sie Rohdaten, Fehler und die genaue Serverkonfiguration zusammen ab.
Pilot abschirmen und instrumentieren
Erfordern Sie Authentifizierung, segmentieren Sie das Netz und beschränken Sie externe Verbindungen. Redigieren Sie Logs und testen Sie die Löschung. Prüfen Sie Zweck, Rechtsgrundlage und externe Beteiligte anhand der DSGVO.
Abnahme und Betrieb organisieren
Nehmen Sie Lastziel und Qualität gemeinsam ab. Dokumentieren und testen Sie Rückfall, Wiederanlauf, Updates und Verantwortlichkeiten.
Die passende Engine auswählen
Ollama liefert einen kurzen Weg zu einem lokalen Pilot. llama.cpp lohnt sich als Kandidat für GGUF und kontrollierten Offload. vLLM sollte sich im gemeinsamen CUDA-Test am gleichen Lastziel messen lassen. Sobald parallele Dokumentanfragen den Speicher füllen, entscheiden zugelassene Kontextlängen, Puffer und stabile Antwortzeiten über den praktischen Nutzen. Wenn das Ziel bei der erwarteten Last verfehlt wird, zeigen Lastfenster und Speicherprotokoll, ob Kontextbudget, Modell oder Auslegung des Dienstes geändert werden sollten.
Quick-Check vor der Hardware-Anschaffung
- Latenz- und Fehlerbudget bei der erwarteten Spitzenlast einhalten.
- Residente Gewichte, KV-Pool, Runtime und freie Reserve dokumentieren.
- Antwortqualität mit der geplanten Quantisierung an typischen Aufgaben prüfen.
- Betriebsaufwand, Zugriffsschutz und Wiederanlauf im selben Pilot erproben.
Häufige Fragen zu lokalen Inferenz-Engines
Was ist Time to First Token (TTFT)?
Zeit vom Absenden der Anfrage bis zum Empfang des ersten generierten Tokens.
Was ist Continuous Batching?
Der Scheduler kann laufende Generierungen und neu zugelassene Anfragen zwischen Rechenschritten gemeinsam einplanen.
Was ist Quantisierung?
Numerische Darstellung mit geringerer Präzision, die je nach Verfahren Gewichtsspeicher spart und die Modellqualität beeinflussen kann.
Offizielle Quellen und Primärdokumentation
- vLLM-Projekt. vLLM v0.34.0 – Extensible KV cache auf CUDA und ROCm.
- Ollama. Release Notes v0.40.16 / v0.40.17-rc4 – Release Notes zu v0.40.16 und v0.40.17-rc4.
- ggml-org. llama.cpp b12590 – Vorabstand und macOS-Builds.
- vLLM-Projekt. vLLM Metal – Apple-Plugin, Modelle und unterstützte Funktionen.
- Meta (2024). Llama 3.1 Model Card – Modellfamilie und Promptformat.
- DeepSeek-AI. DeepSeek-R1 Model Releases – Vollständige R1-Modelle und Destillate.
- Kwon et al. (SOSP 2023). Efficient Memory Management for Large Language Model Serving with PagedAttention – KV-Blöcke und historischer Versuchsaufbau.
- vLLM-Projekt. vllm bench serve – Lasttest am Server-Endpunkt.
- ggml-org. llama.cpp Server Benchmark – Messung über den Server-Endpunkt.
- Ollama. Generate API – Streaming- und Token-Evaluationsfelder.
- ggml-org. llama.cpp Server – Parallele Slots, API und Continuous Batching.
- vLLM-Projekt. Parallelism and Scaling – Modellteilung und Replikation.
- vLLM-Projekt. Quantization – Verfahren und Hardwareunterstützung.
- vLLM-Projekt. GGUF in vLLM – Bedingungen für den GGUF-Lauf.
- ggml-org. GGUF Specification – Container, Gewichte und Metadaten.
- Apple. Mac Studio Tech Specs – Unified Memory und Gerätekonfiguration.
- NVIDIA. GeForce RTX 4090 – Herstellerangaben zum GPU-Speicher.
- NVIDIA. RTX A6000 – Herstellerangaben zum GPU-Speicher.
- Meta. Accelerator Management – Komponenten des Speicherbudgets.
- Ollama. Local FAQ – Betriebsparameter und Parallelität.
- Europäische Union (2016). Verordnung (EU) 2016/679 – Amtlicher Text, insbesondere Art. 5, 6, 25, 28, 32 und Kapitel V.
KI-Automatisierung für Ihr Unternehmen?
Ich setze das für kleine und mittlere Unternehmen um: zum vorab vereinbarten Festpreis und direkt mit dem, der es baut. Ablauf, Umfang und Preise stehen auf der Leistungsseite.
Leistung & Preise ansehen Oder kostenloses Erstgespräch anfragenErweitertes Fachglossar
Time to First Token (TTFT)
Zeit vom Absenden der Anfrage bis zum Empfang des ersten generierten Tokens.
Continuous Batching
Der Scheduler kann laufende Generierungen und neu zugelassene Anfragen zwischen Rechenschritten gemeinsam einplanen.
Quantisierung
Numerische Darstellung mit geringerer Präzision, die je nach Verfahren Gewichtsspeicher spart und die Modellqualität beeinflussen kann.