Google positioniert Gemini 4 Neon zwischen Hydrogen und Carbon. Für Entwicklungsteams zählen neben dem Modell auch die Ausführungsumgebung, die Kosten für wiederholten Kontext und die Qualität der Änderungen, die das Review passieren.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: KI & Automatisierung →
Gemini 4 Neon Benchmark im Überblick
Google hat Gemini 4 Neon am 18. November 2026 als Modell für anspruchsvolle, häufig wiederkehrende Arbeit vorgestellt. In der Gemini-4-Familie ist Hydrogen auf zügige Ausführung ausgelegt, Neon auf komplexe Aufgaben im Alltag und Carbon auf besonders lange, schwierige Arbeitsläufe. Unser Beitrag zu Gemini 4 Argon und Frontier Intelligence betrachtet die Spitze der Modellfamilie. Bei Neon geht es um die Frage, welcher Aufbau für regelmäßig anfallende Arbeit im Repository wirtschaftlich ist. Google · Modellvorstellung
Die wichtigsten Ergebnisse
- Allgemeine Modellleistung. Neon erreicht mit
xhighim Intelligence Index v5.0.1 von Artificial Analysis 61 Punkte und liegt im Releasevergleich auf Platz 3. Artificial Analysis · Releaseanalyse - Coding-Agent. Google nennt zum Launch Rang 1 im Coding Agent Index mit 58,6 Punkten. Die Konfiguration koppelt Neon auf
xhighmit der Antigravity CLI. Google · Launch, Artificial Analysis · Agentenvergleich - API-Standardtarif. Google berechnet pro Million Tokens 3,00 USD für regulären Input, 0,15 USD für gecachten Input und 15,00 USD für Output inklusive Thinking. Google · Developer API Pricing
Release-Stand im November 2026
gemini-4-neon teilt rund eine Million Kontexttokens zwischen Eingabe und Ausgabe. Das synchrone Standardlimit liegt laut Modellreferenz bei 65.536 Ausgabetokens und wird durch den verbleibenden Kontext begrenzt. Der günstigere Inputtarif greift bei einem impliziten Cache-Treffer. Antigravity führte die Neon-Hydrogen-Paarung zum Release mit CLI v1.5.11 ein. Am 19. November ergänzte v1.5.12 die Modellauswahl per API-Schlüssel. Die Developer API läuft im Paid Tier, während Google für Antigravity und die Gemini-App zum Launch Pro und Ultra als Zugangswege nennt. Gemini API · Modellreferenz, Google · Pricing, Antigravity · Changelog, Google · Verfügbarkeit
Coding-Benchmarks und ihre Aussagekraft
Ein Benchmark liefert einen Ausgangspunkt für die Auswahl der Kandidaten. Im eigenen Projekt entscheidet sich die Eignung daran, ob die gewählte Konfiguration die Aufgabe fachlich abschließt und der Patch im Review Bestand hat. Wer überwiegend gewachsene Schnittstellen pflegt, sollte bei der Auswahl auf Aufgaben achten, die Abhängigkeiten zwischen Modulen abbilden. Für ein Team mit viel Build- und Testarbeit können Terminal-Workflows näher am täglichen Aufwand liegen.
Artificial Analysis Coding Agent Index
Artificial Analysis bildet den Coding Agent Index v2.1 aus FrontierCode-AA 2.0 für Implementierungsaufgaben, Terminal-Bench 4.1 für Terminalarbeit und SWE-Atlas-QnA-AA für Fragen zu realen Repositories. Die Teilwerte gehen gleichgewichtet ein. Aufgaben im selben Repository können dabei unterschiedliche Fähigkeiten verlangen. Einen unbekannten Aufrufpfad verständlich zu erklären erfordert etwa andere Schritte, als eine Änderung zu schreiben und sie mit Tests abzusichern. Artificial Analysis · Methodik des Coding Agent Index
Die Konfiguration umfasst Modell, Denkstufe und Agent Harness. Das Harness verwaltet Werkzeugaufrufe und Arbeitszustand und entscheidet beispielsweise, wie Ergebnisse aus dem Terminal an das Modell zurückgehen. Die gerundeten 59 für Neon und je 58 für Fable und Opus im Releasevergleich gehören deshalb zu den im Widget angegebenen Modell–Harness-Paaren. Für die interne Auswahl sind auch Laufzeit und API-Kosten je Aufgabe auf derselben Stichprobe relevant. Artificial Analysis · Releasevergleich
Terminal-Bench, FrontierCode und SWE-sweep
Bei Terminal-Bench 4.1 muss der Agent eine Aufgabe in einer Terminalumgebung bis zum geprüften Ergebnis ausführen. DeepMind weist die Werte als Cheating-adjusted Accuracy aus. Neon kommt mit Antigravity CLI v1.5.9 auf 65,2 %, Opus 5.5 auf 65,8 % und GPT-6.2 Sol auf 61,5 %. Die Auswertung dokumentiert die Vergleichswerte mit den jeweiligen Agentenumgebungen. Für den eigenen Test lohnt es sich, zusätzlich die Fehlerursachen festzuhalten, etwa einen fehlenden Build-Schritt oder einen falsch interpretierten Teststatus. Terminal-Bench · Version 4.1, DeepMind · Evaluationsmethodik, DeepMind · Modellkarte
FrontierCode 2.0 legt den Schwerpunkt auf Änderungen an Repositories. Der Hauptscore liegt für Neon auf high bei 46,2 %, für Opus 5.5 bei 47,3 % und für GPT-6.2 Sol bei 43,8 %. Die AA-Umsetzung und deren Indexanteil werden separat berichtet. SWE-sweep illustriert den Einfluss der Laufzeitumgebung besonders deutlich: DeepMind veröffentlicht für Neon 39,0 % mit Antigravity CLI v1.5.9 und 12,8 % mit mini-SWE als nach Teilaufgaben gewichtete Bewertung. Der Abstand beschreibt die vollständigen Laufkonfigurationen. Wer den Beitrag einer einzelnen Harness-Funktion messen will, variiert diese bei ansonsten gleichem Setup. Cognition · FrontierCode 2.0, DeepMind · Modellkarte, DeepMind · Evaluationsmethodik
Gemini vs Claude Sonnet vs GPT-6
Artificial Analysis weist für Claude Sonnet 5.5 auf max in der Release-Auswertung vom 28. September 56 Punkte im Intelligence Index aus. Die Sonnet-Ergebnisse im Terminal-Bench-Bericht von Artificial Analysis beziehen sich auf Version 4.0 und gehören in eine eigene Vergleichszeile. Die obigen Einzelwerte betreffen Opus 5.5 und GPT-6.2 Sol. Claude Fable 5.2 und GPT-6.2 Astra liegen im allgemeinen Intelligence Index der November-Auswertung jeweils auf max vor Neon. Unser Benchmark-Vergleich von Fable und Astra ordnet diese beiden Varianten ein. Bei Neon zeigt AA auf high gerundet 60 Punkte, ebenso für Carbon auf high. Die Neon-Modellseite nennt 44 Punkte als Median ihrer Vergleichsgruppe. Artificial Analysis · Sonnet-Auswertung, Artificial Analysis · Neon-Releasevergleich, Artificial Analysis · Google-Modelle, Artificial Analysis · Neon-Modellseite
Für mehrstufige Werkzeugnutzung lohnt sich eine gemeinsame Testaufgabe mit festem Ausgangscommit. Lassen Sie jeden Kandidaten einen fehlgeschlagenen Build untersuchen, eine eng umrissene Korrektur vorschlagen und die unabhängige Testprüfung durchlaufen. So lässt sich feststellen, ob die Unterschiede im Repository-Verständnis, bei der Werkzeugnutzung oder erst bei der Qualität des Patches auftreten.
Automatisierung, Wissenschaft und multimodale Analyse
In Zapier AutomationBench 1.0.6 löst Neon simulierte Geschäftsaufgaben über mehrere Anwendungen hinweg. Zapier meldet im Releasebericht 56,3 % auf xhigh und Rang 1, gegenüber 54,3 % auf der Standardstufe high. Prüfen lassen sich damit die korrekte Reihenfolge und Vollständigkeit von Aktionen in der Simulationsumgebung. Für einen eigenen Prozess müssen Zuständigkeiten und Datenqualität gesondert geprüft werden. In Vending-Bench 2 von Andon Labs führt Neon die abgerufene Tabelle mit einem simulierten Endbestand von 16.843,41 USD an. Die ausgewiesene Streuung beträgt ±972 USD. Das Experiment beobachtet Entscheidungen über einen längeren Verlauf bei simuliertem Einkauf, Bestand und Preismanagement. Zapier · Releasebericht, Andon Labs · Vending-Bench 2
DeepMind meldet in Terminal-Bench Science 0.1 einen Average Reward von 70,5 % für wissenschaftliche Terminalaufgaben. RiemannBench kommt auf 84,0 % für mathematische Aufgaben und HLE-Diamond auf 71,3 % für anspruchsvolle Wissens- und Schlussfolgerungsfragen. In Chartography erreicht Neon 73,5 % bei der Interpretation von Diagrammen ohne externe Werkzeuge. In Agents’ Last Exam v1.1 ergibt der Antigravity-CLI-Lauf v1.4.8 einen mittleren Rubrikwert von 75,8 % für realitätsnahe Wissensarbeit. Jede Messung hat einen eigenen Aufgabenmix und eigene Auswertung. Eine bestandene Diagrammfrage liefert beispielsweise weniger Evidenz für den korrekten Umgang mit einer mehrdeutigen Tabelle und ihren Fußnoten. DeepMind · Ergebnistabelle, DeepMind · Testaufbauten
Prompt Caching und LLM-Kosten
Inferenzkosten und Cache-Treffer
Bei Prompt Caching kann der Anbieter bereits verarbeiteten Eingabekontext erneut verwenden. Wiederkehrende Repository-Regeln und gleichbleibende Dokumente bieten sich als gemeinsamer Präfix an. Der aufgabenspezifische Teil folgt danach. Die tatsächliche Wiederverwendung ist aus den Nutzungsdaten je Anfrage abzulesen. Schon umsortierte Dateien oder aktualisierte Anweisungen können den gemeinsam nutzbaren Präfix verkürzen. Bei einem Miss gilt für diese Tokens der reguläre Inputtarif. Implizites Caching ist bei Neon der unterstützte Mechanismus. Der Trefferpreis liegt pro Input-Token 95 % unter dem regulären Preis. Auch die für den Nutzer unsichtbaren Thinking-Tokens gehören zur abgerechneten Ausgabe. Preisvergleich im Widget, Google · Standardtarif
Rechenbeispiel für einen Repository-Workflow
Ein hypothetischer Workflow über mehrere API-Aufrufe verarbeitet insgesamt 0,6 Mio. reguläre und 0,4 Mio. gecachte Input-Tokens und verbraucht 0,1 Mio. abrechenbare Output-Tokens. Bei Tokenzählung in absoluten Zahlen lautet die Formel (uncachedInput × 3 + cachedInput × 0.15 + billableOutput × 15) / 1_000_000. Das ergibt 1,80 USD regulären Input, 0,06 USD Cache-Input und 1,50 USD Output, zusammen 3,36 USD. Wird derselbe Input vollständig regulär abgerechnet, ergeben sich 4,50 USD einschließlich desselben Outputs. Die Mengen sind Beispielannahmen. Google · Preisliste
Für Kosten je akzeptierter Aufgabe summiert das Team die Kosten aller Versuche, einschließlich Wiederholungen und abgebrochener Läufe, und teilt sie durch die Zahl der fachlich akzeptierten Ergebnisse. Externe Tool- und CI-Kosten gehen als eigene Posten ein. Reviewzeit separat in Minuten ausweisen und bei einer Vollkostenrechnung mit einem intern festgelegten Satz bewerten. So bleibt sichtbar, ob ein billigerer Lauf den Aufwand lediglich in die Prüfung verschiebt.
Denken in vier Stufen
low kann für eine klar abgegrenzte Klassifizierung genügen. medium eignet sich als Kandidat für eine kleine Änderung mit eindeutigen Tests. high ist die Vorgabe und ein sinnvoller Ausgangspunkt für Arbeiten mit mehreren abhängigen Schritten. xhigh bietet sich für einen Vergleichslauf an, wenn sich widersprüchliche Befunde über Modulgrenzen hinweg auflösen lassen müssen. Antigravity berichtet für Neon auf high 32 % niedrigere Kosten pro Aufgabe gegenüber Carbon im eigenen Vergleich. Die Ankündigung nennt nur begrenzte Details zur Preisbasis. Artificial Analysis rechnet seinen eigenen Kostenvergleich mit Carbons regulären Preisen ohne Rabatt. Gemini API · Neuerungen in Neon, Antigravity · Releasevergleich, Artificial Analysis · Kosten je Aufgabe
Wann sich high und xhigh lohnen
Starten Sie auf high mit derselben Aufgabe und demselben Harness, die das Team später einsetzen will. Fehlt bei einem mehrstufigen Fehlerbefund ein belastbarer Nachweis, erlauben Sie einen begrenzten Vergleichslauf auf xhigh. Halten Sie vorab Qualitätsziel, Zeitlimit und Kostenobergrenze fest. Stoppen Sie bei erreichtem Limit oder wenn zusätzliche Schritte keine neue überprüfbare Evidenz liefern. Bewerten Sie Zusatzqualität und Mehraufwand auf demselben Aufgabenmix.
Agentic Coding 2026 mit Google Antigravity
Neon plant, Hydrogen führt aus
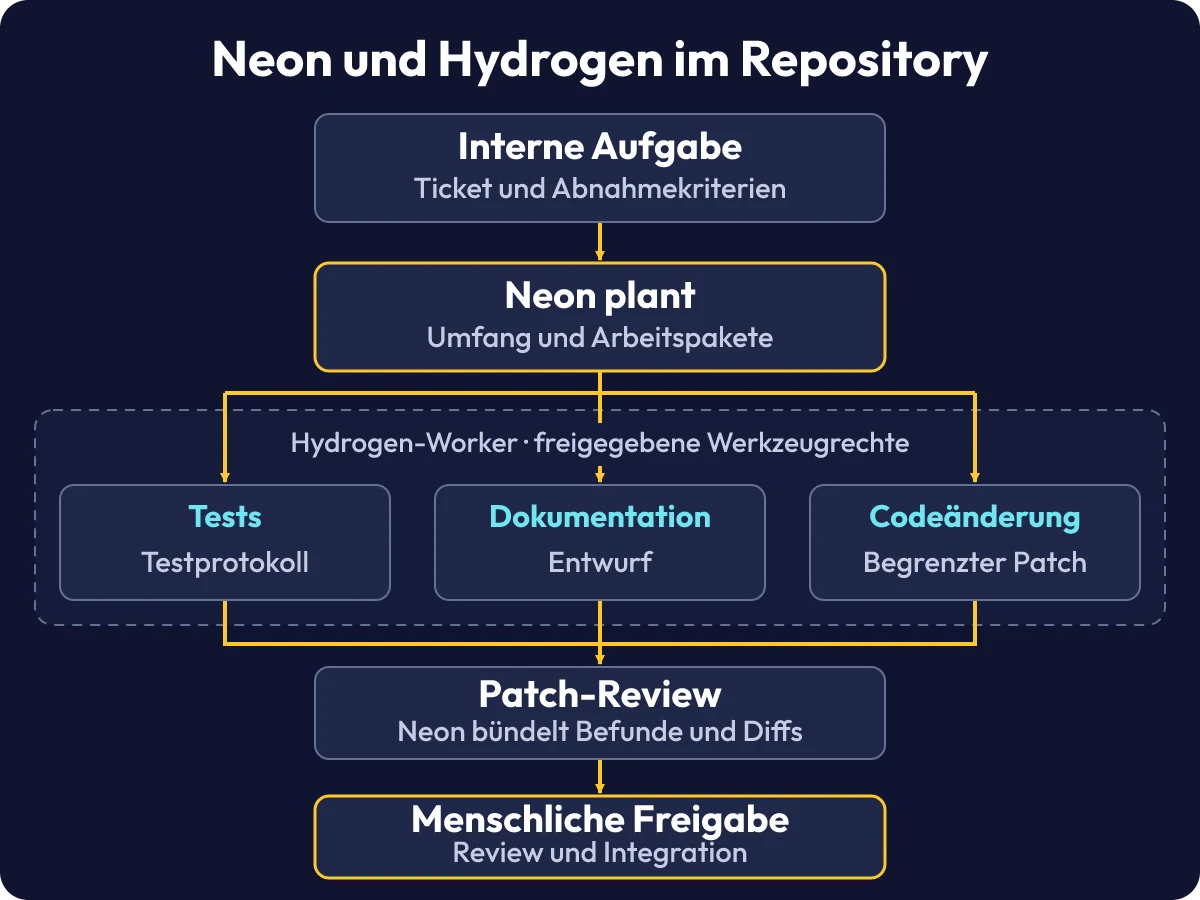
Agentic Coding verbindet Planung, Werkzeugaufrufe und die Überprüfung von Zwischenergebnissen. Google beschreibt den Orchestrator als gemeinsame Sitzung, in der Neon plant und Hydrogen Routineänderungen und Testläufe übernimmt. Bei einem Hindernis geht der Arbeitszustand zur erneuten Planung an Neon zurück. Den separat angekündigten Modus /swarm beschreibt Google als koordinierte Zusammenarbeit paralleler Agenten. Das Diagramm kombiniert diese Rollen als illustratives Szenario für die interne Repository-Pflege. Welche Aufgaben parallel laufen dürfen, entscheidet das Team nach ihren Abhängigkeiten. Google Antigravity · Orchestrator, Google Antigravity · /swarm
Ein Ticket zur Pflege einer internen Bibliothek setzt den Rahmen. Neon formuliert den Plan mit erwarteten Tests und Grenzen für Änderungen. Hydrogen-Aufgaben liefern Testprotokoll, Dokumentationsentwurf und einen begrenzten Patch zurück. Neon fasst Abweichungen zusammen. Eine verantwortliche Person prüft den Diff und erteilt die Freigabe zur Integration. Der Prozess für die Freigabe gehört zur Architektur des Teams. Die Grundlagen zur Aufgabenverteilung erläutert der Beitrag zu Multi-Agenten-Systemen in der Softwareentwicklung.
Aufgabenverteilung
Orchestrierung und Swarm
Geben Sie jedem Worker ein Arbeitspaket mit klaren Zuständigkeiten für Dateien und einem erwarteten Ergebnis. Dokumentation und Testauswertung können parallel laufen, sofern sie auf denselben freigegebenen Stand zugreifen. Änderungen an derselben Stelle werden geordnet bearbeitet. Meldet ein Worker einen Blocker, erhält Neon den Arbeitsstand und die fehlende Voraussetzung.
Quellenprüfung
Multimodale Analyse
Ein Ticket kann Logs, Screenshots und ältere Entwurfsdokumente enthalten. Lassen Sie Befunde mit Dateiname, Fundstelle und Bezug zum geprüften Stand zurückgeben. Im Review reichen für klare Befunde Stichproben. Bei einem Widerspruch zwischen Screenshot und Log wird der betreffende Ausschnitt erneut geprüft und die Unsicherheit im Ticket festgehalten.
Sichere Änderungen
Cyberabwehr und Hardening
Google nennt zum Launch in WebExploitBench v1.2 51,26 % und bezeichnet den Wert sowie 76,0 % im Hard-Split von AutoBaxBench für den jeweiligen Benchmark als damalige Bestleistung. DeepMinds Ergebnistabelle enthält außerdem 90,5 % für SEC-bench Pro und 70,7 % für CWE-bench v2. Für den Pilot wird generierter Code auf sichere Implementierung geprüft. Änderungen durchlaufen ein menschliches Patch-Review und Regressionstests. Google · Release-Angaben zur Cyberabwehr, DeepMind · Modellkarte, DeepMind · Methodik
Budget und Entscheidung
Steuerung der Denkstufen
Halten Sie die gewählte Denkstufe und das zugehörige Zeit- und Kostenlimit im Auftrag fest. Bei Abhängigkeiten mit unklaren Auswirkungen entscheidet der Review-Verantwortliche anhand der vorliegenden Befunde, ob eine Eskalation sinnvoll ist. Der erneute Lauf bekommt dieselben Abnahmekriterien und einen eigenen Kostenposten.
Vom Pilotbetrieb zur produktiven Nutzung
Eine belastbare Einführung beginnt mit einem Aufgabenportfolio, das im Alltag tatsächlich anfällt. Vergeben Sie dieselben Tickets auch an die bestehende Arbeitsweise, damit das Team die ausgelagerte Arbeit und den neu entstehenden Aufwand vergleichen kann. Der Pilot endet mit einer konkreten Entscheidung über die freigegebenen Aufgabenklassen.
-
Umfang und Freigaben festlegen
Engineering Lead und Datenverantwortliche wählen interne Repositories und definieren zulässige Aufgaben, Daten und Werkzeuge. Die Freigabe hält fest, welche Pfade gelesen oder bearbeitet werden dürfen, welche Testumgebung verwendet wird und wer Ausnahmen entscheidet. Legen Sie fest, welche Befunde im Arbeitsprotokoll gespeichert werden dürfen und wie lange sie benötigt werden. Für jedes Ticket beschreibt eine Person vorab das erwartete fachliche Ergebnis. Die Pilotgruppe erhält eine versionierte Aufgabenliste und eine Berechtigungsmatrix, die auch für abgebrochene und neu gestartete Läufe gilt.
-
Baseline und Alternativen messen
QA führt denselben Aufgabenmix mit der bestehenden Arbeitsweise, Neon auf high und den gewählten Alternativen aus. Fixieren Sie Ausgangscommit, verfügbare Werkzeuge, Testdaten und Abnahmekriterien. Pro Versuch erfasst QA fachliche Trefferquote, Zeit bis zur Freigabe, menschliche Reviewminuten, Tokenarten und Kosten einschließlich Wiederholungen. Halten Sie Ergebnisse pro Aufgabenklasse fest. Ein Durchschnitt über sehr unterschiedliche Tickets kann sonst verdecken, dass eine Konfiguration für Routineänderungen gut funktioniert und bei komplexen Pfaden viel Nacharbeit erzeugt.
-
Kontrollierten Pilotbetrieb durchführen
Der Engineering Lead lässt die freigegebenen Aufgaben auf isolierten Arbeitszweigen bearbeiten und überprüft Diffs, Tests und Tool-Protokolle. Das Team stoppt bei überschrittenem Budget, unzulässigem Schreibversuch oder fehlender Evidenz nach der vorgesehenen Wiederholung. Das Pilotprotokoll ordnet jede Abweichung einem Ticket zu und hält fest, wer sie geprüft hat. Für die Entscheidung zählt, welche Aufgaben mit überprüfbarem Ergebnis abgeschlossen wurden und welche menschliche Nacharbeit brauchten. Der Engineering Lead entscheidet nach den vorab vereinbarten Qualitäts- und Kostengrenzen über die nächste Phase.
-
Produktion freigeben und überwachen
Der Service Owner dokumentiert den freigegebenen Aufgabenbereich, die Reviewpflicht, die Kostenobergrenzen und den Rückfall auf die bisherige Arbeitsweise. Starten Sie mit den Aufgabengruppen, deren Ergebnisse im Pilot reproduzierbar waren. Nutzen Sie Fehlerrate, abgebrochene Läufe und Reviewzeit pro Aufgabenklasse als Betriebssignale. Nach einem Wechsel von Modell, Denkstufe, Harness oder Rechten läuft die passende Stichprobe erneut. Für den Rückfall muss klar sein, wer den Agentenzugriff stoppt, laufende Vorgänge übernimmt und die Übergabe im Ticket nachhält.
Stimmen QA und Engineering bei der Bewertung eines Tickets regelmäßig nicht überein, präzisieren sie die Abnahmeregel vor der nächsten Messung. Gerade bei gut klingenden Erklärungen und großen Diffs spart eine vorab definierte Prüfstelle Zeit. Für einen Pilot mit kurzem Durchlauf eignen sich Aufgaben, deren Tests und Review-Anforderungen bereits dokumentiert sind.
Fazit und Entscheidung für den Pilotbetrieb
Neon gehört auf die Shortlist für anspruchsvolle Repository-Arbeit, wenn das Team Antigravity oder einen vergleichbaren Harness evaluieren kann und die Änderungen einem nachvollziehbaren Review unterliegen. Die öffentlichen Werte zeigen, welche Aufgaben sich für eine Vorauswahl anbieten. Für den Vergleich der Wirtschaftlichkeit zählen der konkrete Aufgabenmix, die Kosten jedes Versuchs und der Aufwand bis zur Freigabe. Ein preislich attraktiver API-Lauf kann bei einem fehlenden Regressionstest eine zusätzliche Schleife auslösen. Umgekehrt kann ein höheres Denkbudget bei einem komplizierten Befund sinnvoll sein, wenn es die entscheidende Prüfevidenz liefert.
Geben Sie dem Pilot eine klar formulierte Frage, etwa ob Neon bei isolierbaren Bibliotheksänderungen genauso viele fachlich korrekte Patches liefert wie die bisherige Arbeitsweise und die Reviewzeit im geplanten Rahmen hält. Entscheiden Sie vorab, wie mit fehlenden Tests, verspäteten Ergebnissen und Nacharbeit umgegangen wird. Dann lässt sich ein Pilot auch dann sinnvoll auswerten, wenn mehrere Kandidaten im öffentlichen Vergleich sehr eng beieinanderliegen.
Checkliste für die Evaluierung
Der nächste Entscheidungspunkt ist die Auswertung nach Aufgabenklasse. Engineering und QA geben die Gruppen frei, für die Qualitätsnachweis, Laufzeit und Kosten zusammenpassen. Wenn die Stufe high die Vorgaben erfüllt, liefert sie den Vergleichswert für spätere Änderungen am Setup. Ein begrenzter xhigh-Lauf ist vor allem dort aussagekräftig, wo der fehlende Qualitätsnachweis genau beschrieben und anschließend unabhängig geprüft werden kann.
Offizielle Quellen und Primärdokumentation
- Google DeepMind · Introducing Gemini 4 Neon (18.11.2026). Modellfamilie, Verfügbarkeit und Coding-Ergebnis zum Launch.
- Gemini API · Release notes (18.11.2026). Veröffentlichung der Modellkennung in der API.
- Google Antigravity · Changelog (Abruf 21.11.2026). Release der Orchestrator-Paarung und CLI-Versionen.
- Google DeepMind · Gemini 4 Neon Model Evaluation (Abruf 21.11.2026). Versuchsanordnungen, Herkunft der Vergleichswerte und Bewertung.
- Gemini API · Gemini 4 Neon (Abruf 21.11.2026). Modellkennung, gemeinsame Kontextgrenze und synchrones Ausgabelimit.
- Google · Gemini Developer API Pricing (Abruf 21.11.2026). Standardabrechnung für Input, Cache-Treffer und Output.
- Artificial Analysis · Gemini 4 Neon release analysis (18.11.2026). Releasevergleich für beide Indizes sowie Kosten je Aufgabe.
- Artificial Analysis · Google model comparison (Abruf 21.11.2026). Gerundete Intelligence-Index-Punkte je Denkstufe.
- Artificial Analysis · Gemini 4 Neon model data (Abruf 21.11.2026). Median der Vergleichsgruppe auf der Modellseite.
- Artificial Analysis · Coding Agent Benchmarks (Abruf 21.11.2026). Zusammensetzung und Bewertung des Coding Agent Index.
- Terminal-Bench · Leaderboard (Abruf 21.11.2026). Ergebnisse der agentischen Terminalaufgaben.
- Terminal-Bench · Terminal-Bench 4.1 (09.11.2026). Einordnung des Benchmarks und seiner Prüflogik.
- Google DeepMind · Gemini 4 Neon Model Card (18.11.2026). Ergebnistabelle für Coding, Wissensarbeit, Wissenschaft und Cyberabwehr.
- Cognition · FrontierCode 2.0 (Abruf 21.11.2026). Aufgaben zu Repository-Änderungen und ihre Bewertung.
- Zapier · Gemini 4 Neon on AutomationBench (11.2026). Ergebnis je Denkstufe für simulierte Geschäftsabläufe.
- Andon Labs · Vending-Bench 2 (Abruf 21.11.2026). Simulierter Endbestand und Streuung.
- Google DeepMind · Launch results for cyber defense (18.11.2026). Aggregierte Ergebnisse und Herstellerangaben zu den damaligen Bestwerten.
- Google Antigravity · Gemini 4 Neon in Google Antigravity (18.11.2026). Orchestrator-Rollen und veröffentlichter Vergleich der Kosten je Aufgabe.
- Gemini API · What’s new in Gemini 4 Neon (Abruf 21.11.2026). Denkstufen, Standardverhalten und Kontextfunktionen.
- Google Antigravity · Gemini 4 Carbon and /swarm (10.11.2026). Produktbeschreibung des Modus für parallele Agenten.
- Schema.org · FAQPage (Abruf 21.11.2026). Vokabular für die sichtbaren Glossarfragen.
- Schema.org · HowTo (Abruf 21.11.2026). Vokabular für die sichtbare Einführungsfolge.
- Artificial Analysis · Claude Sonnet 5.5 release analysis (28.09.2026). Intelligence-Index-Ergebnis und separat berichteter Terminal-Bench 4.0.
KI-Automatisierung für Ihr Unternehmen?
Ich setze das für kleine und mittlere Unternehmen um: zum vorab vereinbarten Festpreis und direkt mit dem, der es baut. Ablauf, Umfang und Preise stehen auf der Leistungsseite.
Leistung & Preise ansehen Oder kostenloses Erstgespräch anfragenErweitertes Fachglossar
Was ist Agentic Coding?
Ein KI-Agent plant und bearbeitet Softwareaufgaben in mehreren Schritten. Er nutzt dabei Werkzeuge für Repository-Zugriff, Änderungen und Tests.
Was ist ein Agent Harness?
Die Laufzeitumgebung steuert, wie ein Modell Werkzeuge nutzt, Zustand verwaltet und Aufgaben ausführt. Ihre Konfiguration beeinflusst das Benchmark-Ergebnis.
Was ist Prompt Caching?
Prompt Caching nutzt bereits verarbeiteten Eingabekontext erneut. Bei einem Cache-Treffer kann der Anbieter einen niedrigeren Preis für diese Input-Tokens berechnen.