In einem viel beachteten 45-minütigen Podcast-Gespräch mit Marina Mogilko liefert Felix Rieseberg — Engineering Lead für Claude.ai, Claude Cowork und Claude Code Desktop bei Anthropic — eine schonungslose Bestandsaufnahme: Unternehmen sitzen vor Modellen, die Anthropic-CEO Dario Amodei als „Rechenzentren voller Genies“ beschreibt, bedienen sie aber noch immer wie Chatbots aus dem Jahr 2024. Wir haben das gesamte Interview analysiert und die wichtigsten Architektur-, Prüf- und Führungsprinzipien für den B2B-Alltag aufbereitet.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: KI-Automatisierung für moderne Unternehmen →
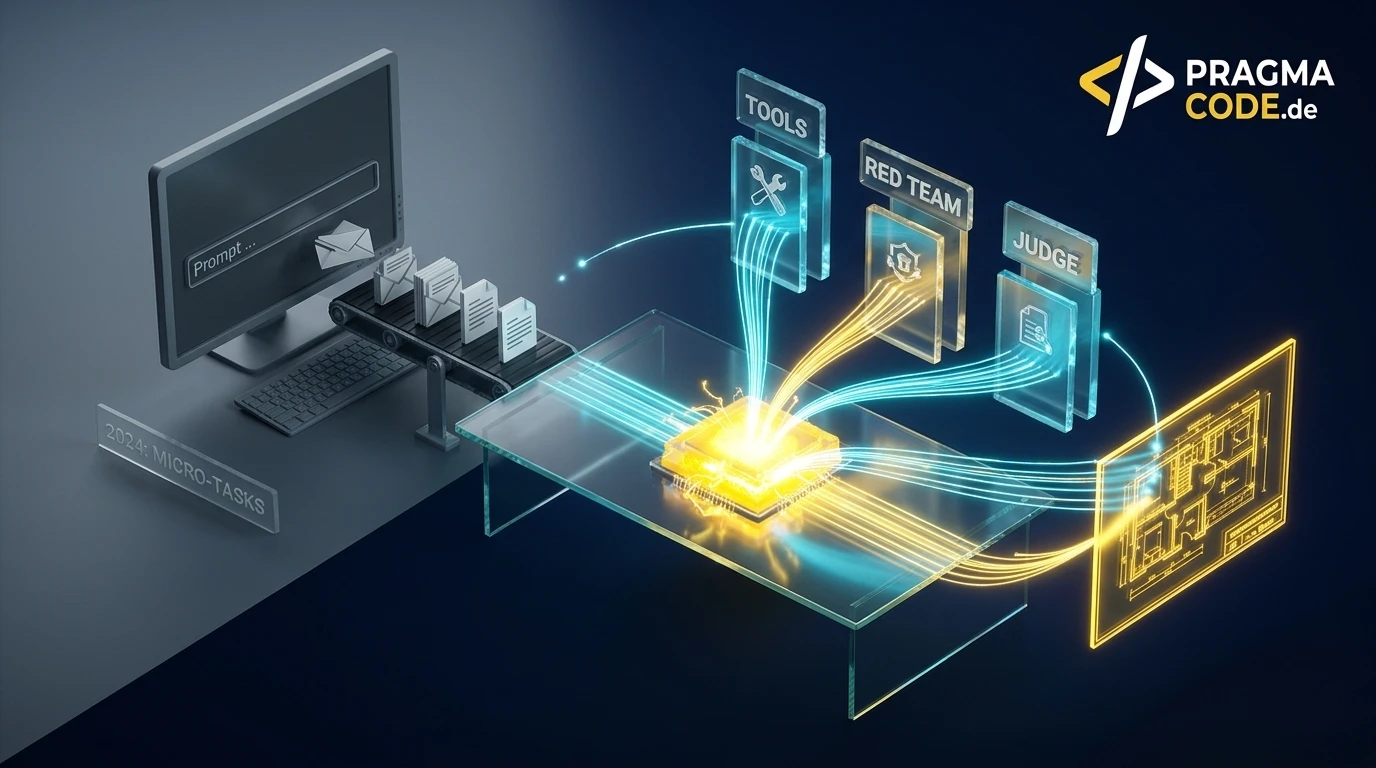
- Die Fähigkeits-Nutzungs-Lücke: Moderne Frontier-Modelle können komplexe Rohdaten durchdringen, Prototypen bauen und eigenständig Werkzeuge bedienen — dennoch stecken viele Teams im 2024-Modus fest und beschränken sich auf E-Mail-Zusammenfassungen, starres Rollen-Prompting und manuelles Copy-Paste.
- Trennung von Erstellung und Prüfung: Felix Rieseberg vertraut niemals einer einzelnen KI-Session, ihre eigene Arbeit zu bewerten. Stattdessen greift ein paralleles Red Team aus 5 bis 10 frischen Streams das Ergebnis an, während eine separate LLM-as-a-Judge-Instanz echte Fehler von Rauschen trennt.
- Empathie und Prozessdesign schlagen reinen Code: Wenn Software-Prototypen innerhalb von Tagen entstehen, liegt der Wettbewerbsvorteil nicht mehr in der Tippgeschwindigkeit oder Framework-Syntax, sondern im Kundenverständnis, in Beziehungen und in der Fähigkeit, veraltete Realwirtschafts-Prozesse grundlegend neu zu denken.
Die Pre-iPhone-Ära der Künstlichen Intelligenz
Im Gespräch mit Marina Mogilko zieht Anthropic-Engineering-Lead Felix Rieseberg einen bemerkenswerten Vergleich: Heutige KI-Anwendungen stehen dort, wo Tastenhandys unmittelbar vor dem ersten iPhone standen. Wer seine Arbeitsabläufe jetzt nicht radikal von Mikro-Befehlen auf zielorientierte Agentic AI-Systeme umstellt, verschenkt den größten Hebel der kommenden Jahre.
- 1. Einleitung: Rechenzentren voller Genies im E-Mail-Modus
- 2. Vom Coder zum Kurator: Automatisierung vs. Augmentation
- 3. Raus aus 2024: Vier KI-Irrtümer, die Unternehmen ausbremsen
- 4. Qualität ohne Fachwissen: Adversarial Verification & Judge-Muster
- 5. Raus aus dem Gründer-Nadelöhr: Eigenen Qualitätsmaßstab skalieren
- 6. Software-Ökonomie, Legacy-Chancen & Karriere im KI-Zeitalter
- 7. 5-Schritte-Roadmap: Vom 2024-Chat zum 2026-Workflow
- 8. Fazit: Der 10-Wochen-Takt der neuen KI-Praxis
1. Einleitung: Rechenzentren voller Genies im E-Mail-Modus
Wenn jemand über die produktive Nutzung von Sprachmodellen spricht, lohnt sich ein genauer Blick auf die Quelle. Am 13. November 2026 veröffentlichte Unternehmerin und Podcasterin Marina Mogilko ein 45-minütiges Gespräch mit Felix Rieseberg (YouTube: „Руководитель Claude: Вы используете ИИ не на полную“; englische Originalfassung im Silicon Valley Girl-Podcast unter dem Titel „Claude Engineering Lead: Stop Using Claude Like It’s 2024“). Rieseberg ist kein außenstehender Kommentator: Der aus Deutschland stammende Software-Architekt leitete zuvor Desktop- und Infrastruktur-Teams bei Microsoft, Slack (wo er das Open-Source-Framework Electron maßgeblich mitprägte), Stripe und Notion. Bei Anthropic verantwortete er als Engineering Lead die Entwicklung von Claude.ai, der Desktop-Version von Claude Code sowie Claude Cowork — jenes Desktop-Agenten-Produkts, dessen erste Fassung sein Team in rund anderthalb Wochen zusammenbaute.
Die Kerndiagnose des Gesprächs trifft den Nerv zahlreicher mittelständischer und großer Organisationen im Jahr 2026: Zwischen dem, wozu moderne Frontier-Modelle fähig sind, und der Art, wie Wissensarbeiter sie im Alltag einsetzen, klafft eine enorme Lücke. Anthropic-CEO Dario Amodei prägte in seinen Essays die Metapher vom „Land voller Genies in einem Rechenzentrum“ („A Country of Geniuses in a Datacenter“). Rieseberg übersetzt dieses Bild in eine unbequeme Alltagsbeobachtung: Viele Profis stehen vor genau diesem Rechenzentrum — und fragen es nach der Hauptstadt Frankreichs oder lassen es den Ton einer einzelnen E-Mail abmildern.
Bemerkenswert an Riesebergs Perspektive ist ihre Bodenständigkeit. Im Gegensatz zu gängigen Hype-Narrativen verspricht er keine magische Vollautomatisierung auf Knopfdruck. Er räumt offen ein, dass ein Befehl wie „Geh los und verdiene Geld“ bei keinem Modell funktioniert, dass eine einzelne Chat-Session sich selbst nur schlecht beurteilen kann und dass alles, was heute als Best Practice gilt, angesichts des exponentiellen Tempos voraussichtlich schon in zehn Wochen wieder auf den Prüfstand gehört. Gerade diese Nüchternheit macht das Interview zu einer wertvollen Orientierung für Geschäftsführer, Produktleiter und IT-Entscheider — eine ideale Ergänzung zu unserer Analyse DHH über Agentic Engineering und die Grenzen von Vibe Coding sowie unserer Untersuchung zu Andrei Doronichev über Digitale Mitarbeiter und die Trust Economy.
2. Vom Coder zum Kurator: Automatisierung vs. Augmentation
Wie sieht der Arbeitstag eines Engineering Leads bei Anthropic aus, der nach eigenen Angaben selbst keinen Quellcode mehr von Hand schreibt? Rieseberg schildert eine Verschiebung nach oben in der Abstraktionshierarchie. Morgens liefern ihm Agenten ein kompaktes Briefing zum Tagesstand. Den überwiegenden Teil seiner Zeit verbringt er jedoch nicht mit Syntax oder Tickets, sondern mit Empathie für Nutzer, Organisationsverständnis, Ideenfindung und schnellem Prototyping. Seine Rolle beschreibt er als ungewöhnliche Mischform aus Produktmanager, technischem Leiter, klassischer Führungskraft und Datenanalyst — weil er immer seltener für jede Teilfrage Spezialisten anderer Abteilungen hinzuziehen muss.
Besonders aufschlussreich ist, wie sich dadurch die Produktbewertung verändert hat. Über 10 bis 15 Jahre hinweg begannen Software-Entscheidungen im Engineering fast immer mit einer impliziten Kostenrechnung: Können wir das bauen? Was kostet die laufende Wartung? Worauf müssen wir im Gegenzug verzichten? Heute lässt Rieseberg Claude alle denkbaren Varianten einer Idee direkt als lauffähige Prototypen bauen, testet sie haptisch und verwirft den Großteil wieder. Denn ein Engpass ist unverändert geblieben: die menschliche Aufmerksamkeit. Selbst wenn KI tausend Varianten pro Tag erzeugen könnte, lässt sich einer Kollegin oder einem Kunden nur ein einziger, kristallklarer Entwurf pro Tag zeigen, bevor der Blick ermüdet. Riesebergs Maßstab für Produktqualität bleibt deshalb ein klassischer Leitsatz: Perfektion ist nicht erreicht, wenn nichts mehr hinzugefügt werden kann, sondern wenn sich nichts mehr weglassen lässt. Das entscheidende Signal ist der Moment, in dem Testnutzer einen Prototyp ausprobieren, es sichtbar „klick“ macht und sie plötzlich Dinge tun können, die zuvor unerreichbar waren.
Der strategische Unterschied: Effizienzgewinn oder neue Fähigkeiten?
Auf Marina Mogilkos Frage, wie er in einem bestehenden Unternehmen — ihrem 35-köpfigen Medien- und Bildungsbetrieb — entscheiden würde, was vollautomatisiert, teilautomatisiert oder in Menschenhand bleibt, trennt Rieseberg zwei Konzepte scharf voneinander:
Automatisierung bedeutet, lästige, zeitraubende oder teure Routineaufgaben aus dem Weg zu räumen, damit Teams sich auf wertschöpfende Arbeit konzentrieren können. Rieseberg betont ausdrücklich, dass genau hier aktuell der klarste messbare wirtschaftliche Return on Investment (ROI) entsteht. Doch der langfristig spannendere Hebel ist für ihn die Augmentation (Erweiterung menschlicher Fähigkeiten): Situationen, in denen Menschen mit KI Dinge leisten, für die ihnen vorher die Fachausbildung, das Werkzeug oder das Grundwissen fehlten.
Als eindrückliches Beispiel aus der Woche vor dem Interview schildert Rieseberg die Geschichte eines Produktmanagers namens Pavel, der offene Datenbestände der NASA an Claude übergab mit dem Auftrag, nach Auffälligkeiten zu suchen — und tatsächlich auf einen möglichen neuen Exoplaneten stieß (wie Rieseberg betont, noch unbestätigt und derzeit in Prüfung durch die NASA). Das Faszinierende daran ist nicht die Astrophysik, sondern das dahinterliegende Muster für jede Wissensarbeit: Wer einen großen, unstrukturierten Datenbestand besitzt, kann ein modernes Modell heute darauf ansetzen, Muster zu entdecken, nach denen das eigene Team mangels Zeit oder Spezialkenntnissen nie gesucht hätte. Voraussetzung dafür ist jedoch die Bereitschaft, den eigenen Arbeitsprozess kritisch zu hinterfragen.
Arbeitsweise im Vergleich: 2024-Gewohnheiten vs. 2026-Workflows
- Mikro-Aufgaben: E-Mails kürzen, Absätze umschreiben oder isolierte Einzelfragen stellen („Hauptstadt von Frankreich“).
- Mensch als Daten-Kurier: Fehlerberichte einzeln öffnen, kopieren, in den Chat einfügen und Antworten manuell zurücktragen.
- Rollen-Theater: Prompts mit „Verhalte dich wie ein Top-Experte“ erzeugen Fachjargon statt echter Methodik.
- Starre Silos: Dutzende vorab definierte Spezial-Agenten mit künstlich begrenzten Mini-Datenschnitten.
- Blinde Selbstprüfung: Dieselbe Chat-Session fragen, ob ihr eigenes Ergebnis korrekt und vollständig ist.
- Ergebnis-Delegation: Übergeordnetes Geschäftsziel formulieren und das Modell bis an reale Leistungsgrenzen fordern.
- Direkter Systemzugriff: Breite Werkzeuge, Rohdaten, Desktop-Browser oder Claude Tag direkt im Team-Kanal anbinden.
- Profi-Methodik & Tools: Das Modell die konkreten Werkzeuge und Zwischenschritte realer Spitzenkräfte anwenden lassen.
- Generalisten mit Werkzeugen: Ein starkes Universalmodell zieht sich per Tool-Calling genau die Daten, die die Aufgabe verlangt.
- Adversarial Verification: Parallele Red-Team-Streams, unabhängiger Judge und primärquellenbasierter Faktencheck.
3. Raus aus 2024: Vier KI-Irrtümer, die Unternehmen ausbremsen
Im Mittelteil des Podcasts räumt Rieseberg gleich mit vier tief verwurzelten Gewohnheiten auf, die sich in den vergangenen zwei Jahren als vermeintliche „Prompting-Standards“ in Unternehmen festgesetzt haben. Besonders wertvoll für IT-Leiter und Fachabteilungen ist dabei, dass er jede Kritik mit konkreten Beobachtungen aus der Praxis und der KI-Forschung begründet.
1. Das „Du bist ein Experte“-Kostüm
Die 2024-Formel „Verhalte dich wie ein erstklassiger Buchhalter oder Ingenieur“ verleitet Modelle laut Rieseberg oft zu reinem Rollenspiel: Sie imitieren den Wortschatz des Berufs, liefern aber nicht zwingend bessere Substanz. Statt eines Kostüms braucht die KI die konkreten Werkzeuge und Zwischenschritte von Profis — etwa echte Animations-Toolchains bei Motion-Design mit Claude Opus 5.5 oder den redaktionellen Streitprozess von Autor Adam Davidson („Stärke das härteste Gegenargument um den Faktor 100“).
2. Der Multi-Agenten-Overkill
Rieseberg äußert eine bewusst kontroverse These: Die Branche übertreibt es mit künstlichen „Schauspiel-Ensembles“ aus vielen rollenbasierten Einzelagenten. Menschen denken gern in Jobtiteln, beschränken dadurch aber die Breite moderner Universalmodelle. Sein historischer Beleg: Google DeepMind erzielte 2024 mit spezialisierten Mathematik-Systemen (AlphaProof/AlphaGeometry 2) Silber bei der Internationalen Mathematik-Olympiade — doch schon kurze Zeit später erreichten allgemeine Frontier-Modelle (Gemini mit Deep Think) Gold-Niveau ohne starre Spezialisierung.
3. Daten-Silos und veraltete Skills
Viele Teams füttern jeden Chat oder Agenten nur mit einem winzigen, vorselektierten Datenausschnitt. Rieseberg vergleicht das mit einem Engineering Manager, der zwar Code sehen darf, aber keinen Zugang zu Kundengesprächen oder Nutzungsdaten erhält: Ohne das Gesamtbild sinkt der Nutzen drastisch. Moderne Modelle sind heute wählerisch genug, um über sauber beschriebene Tools gezielt genau die Daten abzurufen, die sie brauchen. Zugleich warnt er vor blinder Skill-Sammlung: Skills, die für ältere Modellgenerationen geschrieben wurden, veralten extrem schnell — manchmal verbessert sich der Output sofort, wenn man einen alten Skill komplett entfernt.
4. Selbst das menschliche Fließband sein
Noch vor anderthalb Jahren öffnete Rieseberg selbst seine Bug-Liste, kopierte einen Fehler heraus, schickte ihn an Claude und wiederholte den Vorgang beim nächsten Ticket. Seine Erkenntnis: Er war zum menschlichen Fließband verkommen. Sein Tipp für die Perspektivwechsel-Übung lautet: „Versetze dich nicht in den Nutzer, sondern für fünf Sekunden in das Modell.“ Was bräuchtest du als Claude, um das Problem selbstständig zu lösen? Zugang zu den Rohdaten, zu allen Fehlerberichten und zu einem Rechner bzw. Browser.
Gerade der Punkt zu veralteten Skills und starren Projekten verdient im Enterprise-Alltag besondere Aufmerksamkeit. Marina Mogilko schildert im Gespräch ein Dilemma, das viele frühe KI-Anwender kennen: Zu Jahresbeginn wurden umfangreiche Markdown-Regelwerke, Prompt-Vorlagen und isolierte Projekte für das gesamte Team gebaut — ein Jahr später fragt man sich, ob diese Infrastruktur die neuen, fähigeren Modelle nicht eher einengt. Riesebergs pragmatische Antwort: Was nachweislich funktioniert, muss niemand aus Prinzip einreißen. Wer aber mit dem Modellfortschritt wachsen will, sollte regelmäßig einen frischen Chat ohne historische Krücken gegen das bestehende Setup antreten lassen und empirisch prüfen, ob weniger Regelwerk inzwischen bessere Ergebnisse liefert. Wie sich eine solche Umgebung im Software-Kontext konkret anfühlt, beleuchten wir im Detail in unserem Praxistest zu Claude Code Projekten und autonomen Cloud-Threads.
4. Qualität ohne Fachwissen: Adversarial Verification & Judge-Muster
Eine der drängendsten Fragen jeder Führungskraft und jedes Fachexperten stellt Mogilko direkt: Wie verhindert man, auf selbstbewusst vorgetragene KI-Fehler hereinzufallen — besonders in Gebieten, in denen man selbst kein Spezialist ist? Riesebergs Antwort ist ebenso klar wie sofort umsetzbar — und sie beginnt mit einer strikten roten Linie.
„Für mich lautet die Frage weniger, was ich Claude insgesamt nicht anvertrauen würde, sondern was ich einer einzelnen Session — einem einzelnen Chat — nicht anvertraue. Ich möchte fast nie, dass eine laufende Session ihre eigene Arbeit bewertet.“
Ob in Claude Code, Claude Cowork oder einem regulären Projekt: Ein Modell innerhalb desselben Gesprächsverlaufs nach einer Selbstkritik zu fragen, liefert nach Riesebergs Erfahrung selten zuverlässige Urteile. Die Lösung übernimmt er direkt aus der modernen Software-Qualitätssicherung und aus dem Bereich systematischer KI-Evals: Adversarial Verification kombiniert mit einem unabhängigen Judge.
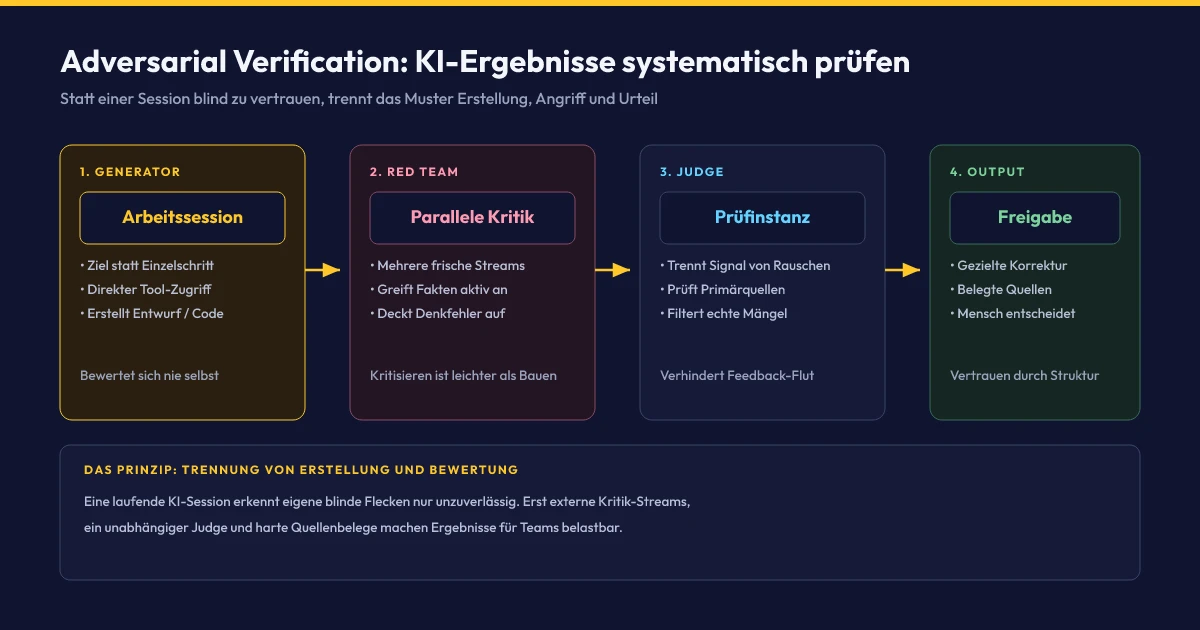
Wie der vierstufige Prüfkreislauf in der Praxis greift
Statt auf den ersten Entwurf zu vertrauen, startet Rieseberg — etwa nach dem Verfassen eines Fachartikels, einer Strategiepräsentation oder eines Architekturkonzepts — fünf bis zehn parallele, unabhängige Prüf-Streams. Ihr einziger Auftrag ist offensiv formuliert: Beweist, dass dieser Entwurf falsch liegt, dass die Argumentation hinkt, dass Fakten nicht stimmen oder entscheidende Perspektiven fehlen. Er vergleicht dieses Vorgehen damit, ethische Hacker gegen die eigene Arbeit anzuheuern oder bewusst „short“ gegen die eigene These zu wetten. Ein praktischer Nebeneffekt für das Budget: Weil es für Modelle genau wie für Menschen deutlich leichter ist, Schwachstellen an einem fertigen Produkt zu finden, als es von Grund auf zu konstruieren, genügt für die Kritik-Streams oft sogar eine günstigere, kleinere Modellstufe.
Wer dieses Verfahren allerdings ungesteuert anwendet, stößt sofort auf ein Folgeproblem, das auch Mogilko aus ihrer Interview-Vorbereitung beschreibt: Fünf verschiedene Modelle oder Streams liefern widersprüchliches Feedback — und am Ende sitzt der Mensch vor einem Berg widersprüchlicher Kommentare. Genau hier greift die dritte Stufe: der Judge (LLM-as-a-Judge). Eine weitere, getrennte Claude-Instanz prüft die Einwände der Red-Team-Streams auf Stichhaltigkeit, verwirft Scheinkritik und gibt nur das belastbare Feedback an den ursprünglichen Arbeits-Thread zurück. Dieser entscheidet, welche Punkte tatsächlich umgesetzt werden. Wenn selbst mehrere Angriffswellen nur noch nebensächliche Detailkritik produzieren, ist das ein verlässlicher Indikator für hohe Belastbarkeit.
Experten-Tipp: Wann Sie 100 % vertrauen können — und wann Ihr Geschmack reicht
Rieseberg unterscheidet sauber zwischen drei Prüf-Szenarien: Bei reinem redaktionellem Fact-Checking („Finde für jede Zahl in diesen Folien eine verlässliche Primärquelle“) vertraut er bereits heute einem einzelnen Agenten zu 100 %. Bei komplexen Fachfragen ohne eigenes Domänenwissen gilt das Motto „mehr Rechenzeit auf das Problem werfen“ — also paralleles Red-Teaming plus Judge. Bei ästhetischen oder nutzungsnahen Ergebnissen hingegen reicht oft die Rolle des anspruchsvollen Kunden: Rieseberg gestaltete seine eigene Website mit 3D-Grafiken neu, ohne je Blender geöffnet zu haben — weil er das visuelle Endergebnis unmittelbar beurteilen konnte.
Genauso wichtig wie die Erkennung harter Fehler ist eine differenzierte Definition von „guter Arbeit“. Rieseberg illustriert das am Beispiel eines Wetter-Agenten: Rät ein Modell zufällig die exakte Außentemperatur, ist das trotzdem ein schlechtes System, weil der Weg zum Ergebnis nicht tragfähig ist. Liegt ein Agent hingegen um ein halbes Grad daneben, hat aber Standort, verlässliche Wetterstationen und Quellen sauber verifiziert, ist der Prozess weitaus wertvoller. Für B2B-Teams deckt sich diese Sicht exakt mit den Prinzipien professioneller Qualitätssicherung, die wir in unserem Leitfaden KI-Evals in der Praxis systematisch herleiten.
5. Raus aus dem Gründer-Nadelöhr: Eigenen Qualitätsmaßstab skalieren
Ein besonders praxisnaher Abschnitt des Podcasts widmet sich einem Problem, das in wachsenden Unternehmen fast zwangsläufig auftritt, sobald Teams produktiv mit KI arbeiten: Die Führungskraft wird zum Nadelöhr. Marina Mogilko beschreibt das Phänomen präzise: Claude liefert rund 70 Prozent eines Textes oder Konzepts, doch die entscheidenden letzten 30 Prozent — Tonalität, strategischer Fokus, redaktioneller Geschmack — fließen erst über ihr persönliches Feedback an das Team ein. Weil kein Agent das Endergebnis nach den manuellen Korrekturen sieht, lernt das System nicht dazu, und am Ende läuft jede Freigabe wieder über den Schreibtisch der Gründerin.
Rieseberg kennt exakt dieselbe Herausforderung aus großen Engineering-Organisationen, in denen jeder Senior-Entwickler beim Code-Review auf andere Nuancen achtet. Seine Lösung erfordert weder ein komplexes Fine-Tuning noch eine monatelange Datenmigration, sondern nutzt die bereits vorhandenen Kommunikationskanäle (etwa GitHub, Slack oder Review-Dokumente) in einem strukturierten Vier-Phasen-Prozess:
Historisches Feedback automatisch einsammeln
Statt eigene Stilregeln mühsam aus dem Gedächtnis aufzuschreiben, erhält Claude direkten Zugriff auf die Kanäle, in denen bisher ehrliches Feedback gegeben wurde (z. B. Slack-Threads, GitHub-Reviews oder Dokumentenkommentare), und sammelt alle historischen Korrekturen eigenständig ein.
Zu expliziten Regeln und Prinzipien verdichten
Im zweiten Schritt komprimiert das Modell die gesammelten Einzelkommentare in ein klares, kompaktes Regelwerk aus Qualitätskriterien, Ausschlusskriterien und Prioritäten, das den tatsächlichen Maßstab der Führungskraft widerspiegelt.
Implizite Entscheidungsmuster aufdecken
Riesebergs Geheimtipp für Schritt drei lautet: „Welche Prinzipien wende ich in meinem Feedback offensichtlich an, ohne dass sie mir selbst bewusst sind?“ Diese Reflexion macht unbewussten Geschmack erstmals artikulierbar und für das gesamte Team transparent.
Parallel-Modus (Shadow Mode) & Team-Einsatz via Claude Tag
Wer noch kein blindes Vertrauen hat, startet im Parallel-Betrieb: Sie prüfen ein Dokument wie gewohnt selbst und lassen Claude parallel seine Bewertung erstellen. Der Abgleich zeigt sofort, wo Übereinstimmung herrscht und wo nachgeschärft werden muss. Für die laufende Zusammenarbeit im Team empfiehlt Rieseberg anschließend Claude Tag in Slack — eine geteilte Claude-Instanz, mit der mehrere Teammitglieder gleichzeitig auf Basis derselben Qualitätsprinzipien arbeiten können.
Selbst bei dieser Methode bleibt Rieseberg realistisch: Auch Menschen urteilen nicht völlig deterministisch — derselbe Vorgesetzte gibt am Montagmorgen oft andere Anmerkungen zu einem Dokument als am Freitagnachmittag. Gerade deshalb wirkt der Parallel-Modus so entlastend: Er ersetzt Führung nicht über Nacht, sondern baut schrittweise messbares Vertrauen auf, während das Team bereits vor dem finalen Management-Review eine erste hochwertige Prüfschleife durchläuft. Wer tiefer in die Frage einsteigen möchte, wie Führungskräfte Teams aus Menschen und autonomen Agenten steuern, findet ergänzende Perspektiven in unserem Beitrag Alien Intelligence: Wie KI-Agenten Führung im Unternehmen verändern.
6. Software-Ökonomie, Legacy-Chancen & Karriere im KI-Zeitalter
Im letzten Drittel weitet sich das Gespräch über einzelne Prompts hinaus auf eine fundamentale wirtschaftliche Frage: Wenn eine Plattform, für die Gründer 2015 noch hunderttausende Dollar Kapital und ein ganzes Entwicklerteam brauchten, heute per Vibe Coding oder Agentic Engineering in zwei Tagen als Prototyp steht — wo liegt dann überhaupt noch der Burggraben von Software-Unternehmen?
Riesebergs Antwort überrascht viele Technologen: Im Kern habe sich weniger geändert, als es auf den ersten Blick scheint. Zwar sinken die Startkosten dramatisch, sodass Teams aus ein bis zwei Personen künftig Milliardenunternehmen aufbauen könnten, und schlechte Software, die Nutzer bislang nur mangels Alternativen zähneknirschend ertragen haben, dürfte vom Markt verschwinden. Doch der wahre Kern eines erfolgreichen Produkts war laut Rieseberg schon immer Empathie für den Nutzer, tiefes Verständnis des zahlungswürdigen Problems und starke Kundenbeziehungen. Er verweist selbstironisch auf einen alten eigenen Blogbeitrag, in dem er das iPhone ohne physische Tastatur einst für Unsinn hielt: Die besten Produkte der Welt sind fast immer solche, die jemand mit außergewöhnlicher Empathie besser erdacht hat, als der Nutzer es sich selbst hätte ausmalen können. In einer Welt, in der reine Umsetzung extrem günstig wird, erlebt gutes Produkt- und Geschäftsverständnis — Rieseberg spricht augenzwinkernd von einer möglichen „Revanche der MBA-Absolventen“ — einen massiven Bedeutungsgewinn.
1. Das unterschätzte Milliardenfeld: Realwirtschafts-Legacy
Im Silicon Valley wirkt es leicht so, als bestehe die Welt aus Start-ups mit neuen MacBooks. Ein Blick hinter Flughafen-Schalter, Hotel-Rezeptionen oder in Zahnarztpraxen zeigt das Gegenteil: Ein gewaltiger Teil der Realwirtschaft läuft auf schwerfälliger Windows-Software oder schwarz-weißen Text-Terminals. Genau hier liegt ein riesiges, kaum bearbeitetes Marktpotenzial für praxisnahe Modernisierung.
2. Echte KI-Integration statt billiger FAQ-Seitenleiste
Rieseberg kritisiert, dass die Branche unzählige Produkte mit schwachen, billigen Chatbots in der Seitenleiste überzogen hat, die kaum mehr können als eine FAQ-Seite vorzulesen. Die nächste Generation erfolgreicher B2B-Software bettet leistungsstarke Frontier-Modelle tief in den Kernprozess ein und passt sich dynamisch an den jeweiligen Anwender an.
3. Neue Entwickler-Identität: System-Kombination statt Syntax
Ingenieure durchlaufen laut Rieseberg eine Identitätskrise: Jede Funktion einer Bibliothek wie React auswendig zu kennen, verliert rasant an Marktwert. Gefragt sind stattdessen Menschen, die fünf bestehende Systeme intelligent verbinden, reale Nutzerprobleme lösen und ihre Kompetenz durch greifbare, funktionierende Projekte statt durch bloße Zertifikate belegen.
4. Praxis schlägt Elfenbeinturm: Das Waterloo-Prinzip
Aus eigener Erfahrung vergleicht Rieseberg die stark theoretische deutsche Informatikausbildung mit dem praxisorientierten Co-op-Modell der kanadischen University of Waterloo. Studierende, die bereits vier oder fünf Praktika in realen Unternehmen absolviert haben, wissen, wie man Ideen durchsetzt, Ressourcen gewinnt und mit Fachabteilungen oder Juristen abstimmt — und liefern ab Tag eins mehr Wirkung als reine Theoretiker.
Besonders deutlich wird diese Perspektive im Abschnitt über Nachwuchskräfte und Recruiting. Sowohl Mogilko als auch Rieseberg betonen, dass Abschlüsse und Universitätsnamen zweitrangig werden, sobald greifbare Arbeitsproben vorliegen. Wer als Berufseinsteiger in den kommenden drei Jahren gefragt bleiben will, sollte nicht Frameworks pauken, sondern ein Portfolio echter, nutzbarer Produkte aufbauen, Kunden verstehen und zeigen, dass er Wichtiges von Unwichtigem trennen kann. Gerade junge Talente passen sich laut Rieseberg oft schneller an diese neue Realität an als erfahrene Entwickler, die jahrelang gewohnt waren, schlicht Tickets abzuarbeiten, ohne nach dem dahinterliegenden Geschäftszweck zu fragen.
7. 5-Schritte-Roadmap: Vom 2024-Chat zum 2026-Workflow
Wie übertragen Geschäftsführer, Produktverantwortliche und IT-Teams die Impulse aus dem Gespräch strukturiert in den eigenen Betrieb, ohne in Aktionismus oder teure Architektur-Sackgassen zu geraten? Die folgende fünfstufige Roadmap verdichtet Riesebergs Empfehlungen in einen unmittelbar umsetzbaren Fahrplan — passend zu den Best Practices aus unserem Architektur-Guide Agentic AI Workflows 2026:
-
1. Niedrigschwellig starten statt wochenlang vorbereiten
Verzichten Sie zu Beginn auf endlose Stilhandbücher, komplexe Datenexporte oder künstliche Agenten-Organigramme. Starten Sie nach Riesebergs Empfehlung mit der Desktop-App von Claude (inklusive integriertem Browser und Claude Cowork), lassen Sie das Modell direkt an realen Aufgaben im Browser arbeiten und beobachten Sie, in welchen Prozessen der größte Hebel entsteht. Erst wo sich ein Ablauf bewährt, lohnt sich der direkte API- oder MCP-Anschluss.
-
2. Fließband-Arbeit abschaffen und Ziele statt Einzelschritte übergeben
Identifizieren Sie alle Abläufe, in denen Mitarbeitende heute manuell Fehlerberichte, Kundenanfragen oder Tabellen in Chatfenster kopieren. Stellen Sie sauberen, rechtebasierten Werkzeugzugriff auf die Rohdaten bereit und formulieren Sie das gewünschte Gesamtergebnis — inklusive der Methoden und Profi-Werkzeuge, die angewendet werden sollen, statt oberflächlicher Experten-Rollenspiele.
-
3. Adversarial Verification & Primärquellen-Checks verankern
Legen Sie teamweit fest, dass keine kritische Ausarbeitung (Vertragsentwurf, Architekturkonzept, Analyse oder Präsentation) allein von ihrer Erstellungs-Session abgenommen wird. Etablieren Sie ein leichtgewichtiges Red-Team-Verfahren mit mehreren parallelen Kritik-Streams, einer separaten Judge-Instanz und verpflichtender Primärquellen-Prüfung für jede genannte Zahl.
-
4. Führungs-Feedback extrahieren und im Parallel-Modus validieren
Lösen Sie das Entscheider-Nadelöhr schrittweise auf: Lassen Sie Claude historische Kommentare aus Slack, GitHub oder Dokument-Reviews zu expliziten Qualitätsprinzipien verdichten, testen Sie die KI einige Wochen im Parallel-Betrieb gegen Ihre eigenen Reviews und rollen Sie das abgestimmte Regelwerk danach über kollaborative Kanäle wie Claude Tag ins Team aus.
-
5. Den 10-Wochen-Audit für Skills und Workflows einführen
Riesebergs abschließende Warnung gehört fest in den Unternehmenskalender: Prüfen Sie Ihre gespeicherten Skills, System-Prompts und Multi-Agenten-Ketten alle zwei bis drei Monate kritisch gegen ein frisches Frontier-Modell ohne Ballast. Alles, was nur als Krücke für die Vorgängergeneration diente und heute Qualität oder Tempo bremst, wird konsequent gestrichen.
Quick-Check: Arbeitet Ihr Team bereits im 2026-KI-Modus?
8. Fazit: Der 10-Wochen-Takt der neuen KI-Praxis
Das Interview zwischen Marina Mogilko und Felix Rieseberg wirkt deshalb so klärend, weil es die Diskussion um Künstliche Intelligenz von abstrakten Zukunftsvisionen zurück auf die konkrete Arbeitsebene holt. Wir befinden uns nicht am Ende der KI-Evolution, sondern in einer frühen Übergangsphase — vergleichbar mit den Monaten vor dem Durchbruch des Smartphones. Wer das exponentielle Tempo unterschätzt, wird regelmäßig davon überrascht, wie schnell gestern noch unlösbare Aufgaben zum Standard werden.
Für Unternehmen im deutschsprachigen Raum lautet die zentrale Lehre: Der Engpass ist 2026 selten der Zugang zu einem noch besseren Modell, sondern die eigene Prozessreife. Wer aufhört, KI als überdimensionierten E-Mail-Assistenten im 2024-Stil zu bedienen, Daten-Silos durch durchdachten Tool-Zugriff ersetzt, Erstellung und Prüfung über Adversarial Verification sauber trennt und menschliche Empathie konsequent in den Mittelpunkt der Produktentwicklung stellt, sichert sich einen dauerhaften Vorsprung — gerade in den traditionsreichen Branchen der Realwirtschaft, in denen veraltete Software-Landschaften auf echte Erneuerung warten.
Offizielle Quellen & Primärdokumentation
- Marina Mogilko (YouTube, 13.11.2026): „Руководитель Claude: «Вы используете ИИ не на полную»“ – Vollständiges 45-minütiges Podcast-Interview mit Felix Rieseberg (Grundlage dieser Analyse).
- Silicon Valley Girl / Marina Mogilko (YouTube, 2026): „Claude Engineering Lead: Stop Using Claude Like It’s 2024“ – Englische Originalfassung des Gesprächs mit Felix Rieseberg.
- Felix Rieseberg (Offizielles Profil): „Felix Rieseberg – Engineering Leadership & Projects“ – Beruflicher Werdegang (Anthropic, Notion, Stripe, Slack/Electron, Microsoft).
- Anthropic Support-Dokumentation (2026): „Get started with Claude Cowork“ – Offizielle Dokumentation zur agentischen Desktop-Arbeitsumgebung Claude Cowork.
- Anthropic Newsroom (2026): „Introducing Claude Tag“ – Offizielle Ankündigung von Claude Tag für kollaborative Team-Workflows direkt in Slack.
- Dario Amodei (Oktober 2024 & Januar 2026): „Machines of Loving Grace“ sowie „The Adolescence of Technology“ – Primärquellen zur im Podcast zitierten Metapher „A Country of Geniuses in a Datacenter“.
- Google DeepMind (Juli 2024 & Juli 2025): „AI achieves silver-medal standard solving International Mathematical Olympiad problems“ und „Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the IMO“ – Offizielle Belege für den im Podcast beschriebenen Übergang von spezialisierten Systemen zu Generalisten-Modellen.
Unsere Expertise vor Ort
Wir sind Ihr digitaler Partner – regional verankert und überregional erfolgreich.
KI-Automatisierung für Ihr Unternehmen?
Ich setze das für kleine und mittlere Unternehmen um: zum vorab vereinbarten Festpreis und direkt mit dem, der es baut. Ablauf, Umfang und Preise stehen auf der Leistungsseite.
Leistung & Preise ansehen Oder kostenloses Erstgespräch anfragenErweitertes Fachglossar
Claude Cowork
Eine von Anthropic entwickelte agentische Desktop-Arbeitsumgebung, die die autonome Arbeitsweise von Claude Code aus dem Entwickler-Terminal auf allgemeine Wissensarbeit überträgt und mehrstufige Aufgaben mit direktem Datei- und Browserzugriff ausführt.
Claude Tag
Anthropics kollaborative Slack-Integration für Team- und Enterprise-Kunden, bei der eine geteilte Claude-Instanz per @Claude-Erwähnung direkt im Kanal mitarbeitet, Thread-Kontexte versteht und Aufgaben asynchron für das gesamte Team ausführt.
Adversarial Verification
Ein Qualitätssicherungsmuster für KI-Systeme, bei dem unabhängige Prüf-Sessions (Red Team) einen generierten Entwurf gezielt auf Fakten-, Logik- und Architekturfehler angreifen, bevor eine separate Prüfinstanz das Ergebnis freigibt.
LLM-as-a-Judge
Bewertungsverfahren, bei dem ein separates Sprachmodell als unabhängige Prüfinstanz die Ausgaben oder Kritikpunkte anderer KI-Sessions anhand definierter Kriterien gewichtet und zwischen berechtigten Mängeln und Rauschen unterscheidet.
Agentic Engineering
Entwicklungsansatz, bei dem autonome KI-Agenten mehrstufige Entwicklungsaufgaben wie Planung, Codierung, Testen und Refactoring unter menschlicher Architektur- und Qualitätskuratierung ausführen.
Vibe Coding
Ein informeller Entwicklungsansatz, bei dem Nutzer Software primär über natürlichsprachige Prompts generieren lassen, ohne den erzeugten Quellcode oder die zugrunde liegende Systemarchitektur im Detail zu prüfen.