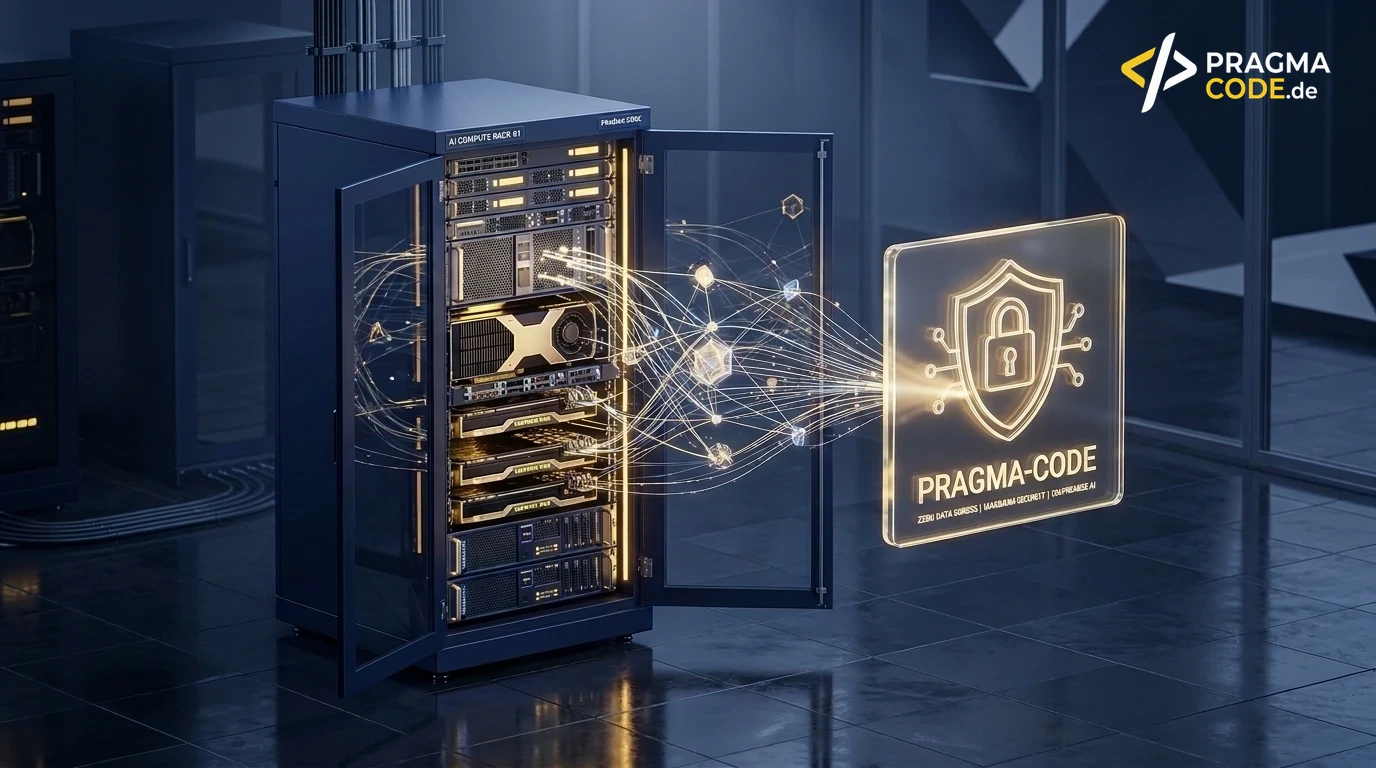
Geschäftsgeheimnisse, proprietärer Quellcode und vertrauliche Kundendaten gehören nicht in fremde US-Hyperscaler-Clouds. Erfahren Sie in diesem umfassenden Architektur-Leitfaden, wie mittelständische Unternehmen mit quantisierten Open-Weight-Modellen, vLLM Inferenz-Clustern, lokaler RAG-Integration und Air-Gapped-Netzwerkstrukturen echte Modell-Souveränität realisieren und die DSGVO-Konformität erleichtern.
Dieser Artikel ist ein vertiefender Fachbeitrag aus unserem Content-Cluster. Entdecken Sie die vollständige Übersicht auf unserer Hauptseite: KI-Beratung & Integration →
- Datensouveränität statt Cloud-Abhängigkeit: Der On-Premise-Betrieb erleichtert die DSGVO-Konformität und schließt Zugriffe nach US CLOUD Act weitgehend aus, sofern keine US-Dienstleister Zugriff haben (Support, Telemetrie, Updates). Bei Open-Weight-Modellen auf eigener Firmen-Hardware und sauber umgesetztem Air-Gapping verlassen vertrauliche Konstruktionsdaten, Kundenakten und Bilanzen das lokale Rechenzentrum nicht.
- Kalkulierbare Fixkosten statt Token-Explosion: Die Investition in ein dezidiertes Inferenz-Rack kann sich bei hohem Dokumenten- und Automatisierungsvolumen gegenüber cloudbasierten API-Abonnements nach grob 6 bis 8 Monaten amortisieren (Erfahrungswert, grobe Schätzung ohne Strom, Wartung und Personal).
- Enterprise-Performance durch vLLM & Hybrid RAG: Moderne Inferenz-Server mit PagedAttention und Continuous Batching bedienen dutzende gleichzeitige Mitarbeiteranfragen (abhängig von GPU, Modell und Kontextlänge) – gekoppelt an rollenbasierte Vektordatenbanken (pgvector / Qdrant).
- 1. Warum DACH-Unternehmen auf On-Premise LLMs setzen
- 2. Hardware-Dimensionierung: VRAM-Bedarf, GPUs & Small Data Center
- 3. Inferenz-Engines im Enterprise-Härtetest: vLLM vs. Ollama vs. TGI
- 4. Die 4 Säulen einer sicheren Enterprise RAG-Plattform
- 5. Netzwerk-Integration & Orchestrierung mit n8n & MCP
- 6. IT-Sicherheit, Air-Gapping & DSGVO-Compliance
- 7. 5-Schritte-Roadmap: Vom PoC zum produktiven On-Premise LLM
- 8. Quick-Check & Strategisches Fazit
Die Reifeprüfung lokaler Unternehmens-KI
Der Abstand zwischen proprietären Cloud-Modellen und Open-Weight-Architekturen hat sich für viele Unternehmensaufgaben verkleinert. Etablierte Open-Weight-Modelle wie Llama 3.3 (70B), Qwen 2.5 Coder oder DeepSeek-V3 lassen sich auf unternehmenseigener Hardware betreiben; ob sie für den eigenen Anwendungsfall ausreichen, sollte vorab gemessen werden. Für den europäischen Mittelstand verschiebt sich die strategische Leitfrage daher grundlegend: Nicht mehr ob lokale KI betrieben werden kann, sondern wie das Inferenz- und RAG-Ökosystem architektonisch gehärtet, netzwerktechnisch segmentiert und wirtschaftlich skaliert wird.
1. Warum DACH-Unternehmen auf On-Premise LLMs setzen
Im Zuge der rasanten Verbreitung generativer Sprachmodelle haben viele Unternehmen erste Gehversuche mit US-amerikanischen Cloud-APIs unternommen. Was in agilen Pilotprojekten vielversprechend begann, konfrontiert Datenschutzbeauftragte, CISOs und Finanzvorstände im Produktivbetrieb zunehmend mit unlösbaren Zielkonflikten. Drei fundamentale Faktoren treiben die strategische Rückbesinnung auf das eigene Rechenzentrum:
1. Unkontrollierbare Compliance- & IP-Risiken
Werden sensible Forschungsberichte, Fertigungszeichnungen, juristische Verträge oder Patientendaten an US-Cloud-Endpunkte übermittelt, kann bei US-Anbietern der US CLOUD Act greifen. Selbst bei vertraglich zugesicherter Serverlokation in der EU können US-Behörden von US-Anbietern die Herausgabe von Daten verlangen. Für Wirtschaftsprüfer, KRITIS-Betreiber und sensible Branchen (Medizin, Rüstung, Sondermaschinenbau) stellt diese Drittlandübermittlung nach Art. 44 ff. DSGVO ein erhebliches Haftungsrisiko dar.
2. Die SaaS- & Token-Kostenfalle bei Skalierung
Cloud-Anbieter monetarisieren jeden API-Call nach Token-Verbrauch. In datenintensiven B2B-Prozessen – etwa dem automatisierten Abgleich tausender monatlicher Rechnungs-PDFs, dem Parsen technischer Datenblätter oder unternehmensweiten RAG-Suchen – explodieren die Monatsrechnungen exponentiell. Hinzu kommen unberechenbare Verbrauchsmodelle wie Microsoft Copilot Credits, die Budgetplanungen im Controlling regelmäßig sprengen.
Demgegenüber entkoppelt ein On-Premise LLM das operative Unternehmenswachstum von variablen Softwarelizenz- und Tokenkosten. Ist die Hardware einmal im Firmennetzwerk installiert, liegen die Grenzkosten pro Token nahe null; es bleiben Fixkosten für Hardware, Strom und Betrieb.
Experten-Tipp: Der TCO-Kipppunkt (Break-Even-Analyse)
Als Faustformel für den DACH-Mittelstand gilt: Verarbeitet ein Unternehmen in automatisierten Prozessen oder Mitarbeiter-Chats mehr als 15 Millionen Tokens täglich, kann sich ein dedizierter GPU-Inferenzserver (Anschaffungskosten je nach Ausbaustufe ca. 25.000 € bis 45.000 €, siehe Tabelle in Abschnitt 2) gegenüber vergleichbaren Kosten aktueller Frontier-Cloud-APIs nach grob 6 bis 8 Monaten amortisieren. Das ist ein Erfahrungswert und eine grobe Schätzung ohne Strom, Wartung und Personal – keine Messung.
2. Hardware-Dimensionierung: VRAM-Bedarf, GPUs & Small Data Center
Der häufigste und kostspieligste Fehler bei der Beschaffung lokaler KI-Hardware ist eine fehlerhafte VRAM-Dimensionierung. Im Gegensatz zu traditionellen Enterprise-Servern, bei denen CPU-Taktrate und RAM-Kapazität dominieren, wird die Leistung eines Inferenz-Servers maßgeblich durch die Speicherkapazität (VRAM) und Speicherbandbreite (GB/s) der Grafikprozessoren bestimmt.
Die exakte Formel zur VRAM-Berechnung
Um ein Sprachmodell verlässlich und performant im Multi-User-Betrieb bereitzustellen, reicht es keineswegs aus, lediglich die Dateigröße der Modellgewichte in den Grafikspeicher zu laden. Der gesamte VRAM-Bedarf setzt sich aus drei zwingenden Komponenten zusammen:
1. Statischer Speicher für Modellgewichte (Weights)
Hängt direkt von der Parameteranzahl (z. B. 8B, 32B, 70B) und der Quantisierungspräzision ab. Ein 70B-Modell benötigt in unkomprimiertem FP16 volle 140 GB VRAM. Bei 4-Bit-Quantisierung (AWQ oder EXL2) schrumpft der statische Speicherbedarf auf ca. 38 bis 42 GB. 4-Bit-Quantisierung (AWQ) kostet typischerweise wenig Qualität, sollte aber am eigenen Anwendungsfall gemessen werden.
2. Dynamischer Speicher für den Key-Value-Cache (KV-Cache)
Jeder Token, den das Modell im Kontextfenster hält (z. B. 8.192 bis 32.768 Tokens pro Anfrage), belegt dynamischen Speicher für die Attention-Berechnung. Rechenbeispiel für Llama 3.3 70B (80 Layer, 8 KV-Heads, Head-Dimension 128, FP16-Cache): 2 (Key und Value) × 80 × 8 × 128 × 2 Byte = 327.680 Byte ≈ 0,33 MB pro Token. Bei 16.384 Tokens sind das ≈ 5,4 GB pro Anfrage; 50 parallele Anfragen mit vollen 16k-Kontexten kämen auf ≈ 268 GB (mit FP8-KV-Cache ≈ 134 GB). In der Praxis reserviert vLLM den Cache dynamisch (PagedAttention), und selten sind alle Anfragen gleichzeitig voll belegt. Mit kürzerem Kontext von 4.096 Tokens ergeben sich ≈ 1,3 GB pro Anfrage und für 50 Anfragen ≈ 67 GB (FP16). Zusammen mit ca. 40 GB Gewichten sind das gut 100 GB vor dem Sicherheitszuschlag – 2 GPUs mit 96 GB reichen dafür nicht, 4 GPUs mit 192 GB schon. Wird der Speicher knapp, bricht die Inferenz ab (Out-of-Memory CUDA Crash).
3. Inferenz-Overhead & CUDA-Runtime-Puffer
Das Betriebssystem, CUDA-Bibliotheken, Tensor-Parallelism-Kommunikationskanäle und temporäre Aktivierungsmatrizen erfordern als Faustregel einen Sicherheitszuschlag von etwa 15 bis 20 % des gesamten physischen VRAMs.
Hardware-Architekturen im direkten Unternehmensvergleich
Je nach Unternehmensgröße, Sicherheitsniveau und räumlicher Infrastruktur haben sich im DACH-Mittelstand drei dominante Hardware-Klassen für den Betrieb von lokalen LLMs etabliert:
| Hardware-Klasse | Typische Spezifikation | VRAM & Bandbreite | Zielmodelle & Workload | Investition & Einsatzbereich |
|---|---|---|---|---|
| Enterprise GPU-Server (19″ Rack) | 2x bis 4x NVIDIA RTX 6000 Ada / L40S, Dual AMD EPYC, 512 GB DDR5 RAM | 96 GB bis 192 GB GDDR6 (bis 960 GB/s pro GPU) | Llama 3.3 70B (AWQ/FP8) mit hohem Paralleldurchsatz (viele gleichzeitige Nutzer, abhängig von Kontextlänge und Quantisierung) | ca. 25.000 € – 45.000 €; klassischer Firmen-Serverraum mit 19-Zoll-Klimatisierung |
| Mittelstands-Workstation / Entry-Cluster | 2x NVIDIA GeForce RTX 4090 (24 GB) mit Blower-Kühlung, PCIe 4.0, 128 GB RAM | 48 GB GDDR6X (1.008 GB/s pro GPU) | Qwen 2.5 32B (Q4/Q8) oder Llama 3.3 70B (EXL2 stark quantisiert, bis 15 User) | ca. 8.000 € – 12.000 €; agile Abteilungs-Server oder dedizierte R&D-Labore |
| Apple Silicon Unified-Memory Cluster | Mac Studio M2/M3 Ultra, 24-Core CPU, 76-Core GPU, 192 GB Unified Memory | 192 GB Unified Memory (800 GB/s Systembandbreite) | Llama 3.3 70B (Q8 / unkomprimiert) oder 120B+ Modelle bei geringer Concurrency (1–10 User) | ca. 8.500 €; geräuschloser Betrieb direkt im Großraumbüro ohne Serverraum-Kühlung |
Zur Einordnung: DeepSeek-V3 (671 Mrd. Parameter, Mixture-of-Experts mit 37 Mrd. aktiven Parametern) braucht selbst quantisiert über 300 GB VRAM (Gewichte in FP8 ≈ 671 GB, in 4-Bit ≈ 336 GB) und damit einen Mehr-GPU-Server der H100/H200-Klasse. Auf die oben gezeigten Konfigurationen passt es nicht.
Das B2B Small Data Center: Physische Infrastruktur im Firmen-Serverraum
Wer Enterprise-KI On-Premise betreibt, benötigt kein Hyperscaler-Rechenzentrum, sondern ein professionell aufgesetztes Small Data Center. Ein solches Server-Rack im hauseigenen Technikraum muss vier grundlegende Betriebsbedingungen erfüllen:
Thermische Lastabfuhr
Ein Server mit vier Enterprise-GPUs erzeugt unter Volllast zwischen 1.200 und 1.800 Watt Abwärme. Eine redundante In-Row- oder Raum-Klimatisierung mit Kaltgang-Einhausung ist Pflicht, um thermisches Throttling der GPUs zu verhindern.
Unterbrechungsfreie Stromversorgung (USV)
Spannungsspitzen oder kurzzeitige Netzausfälle führen bei laufenden Vektor-Indizierungen oder Inferenz-Jobs zu fatalen Datenbank-Korruptionen. Eine Online-Dauerwandler-USV mit mindestens 15 Minuten Pufferzeit schützt die Hardware.
NVMe-Storage mit hohem Durchsatz
Das Laden eines 70B-Modells in den VRAM beansprucht über gewöhnliche SATA-SSDs spürbar länger. PCIe 4.0/5.0 NVMe-RAID-Verbünde (Leseraten > 7.000 MB/s) verkürzen Modellwechsel und Systemstarts deutlich.
3. Inferenz-Engines im Enterprise-Härtetest: vLLM vs. Ollama vs. TGI
Die Wahl der ausführenden Inferenz-Software entscheidet maßgeblich darüber, wie viele Anfragen Ihre Hardware gleichzeitig verarbeiten kann, bevor die Antwortzeiten für Mitarbeiter ins Unerträgliche steigen. Viele Unternehmen begehen den Fehler, Werkzeuge aus dem Entwickler-Umfeld unkritisch in den Produktivbetrieb zu übernehmen.
Hinweis zu TGI: Hugging Face Text Generation Inference (TGI) befindet sich laut Hugging Face im Wartungsmodus; Hugging Face empfiehlt für neue Projekte vLLM oder SGLang. TGI wird deshalb hier nicht weiter betrachtet.
Vergleichsanalyse: Entwickler-Runtime (Ollama) vs. Enterprise-Inferenz (vLLM)
- Batching-Modell: Parallele Anfragen sind möglich (Umgebungsvariable
OLLAMA_NUM_PARALLEL, siehe Ollama-FAQ). - Speichermanagement: Einfache VRAM-Verwaltung ohne PagedAttention.
- Skalierbarkeit: Für Einzelplatz und kleine Teams optimiert; für hohen Parallelbetrieb ist vLLM mit Continuous Batching besser geeignet.
- Multi-GPU-Support: Einfaches Layer-Offloading über llama.cpp, aber kein echtes Tensor-Parallelism.
- Ideal für: Lokale Entwickler-Laptops, Einzelplatz-Workstations und schnelle Machbarkeits-PoCs.
- Batching-Modell: Echtes Continuous Batching (Iteration-Level-Scheduling) ohne Wartezeiten.
- Speichermanagement: Revolutionäre PagedAttention (virtuelle Speicherverwaltung wie im Betriebssystem).
- Skalierbarkeit: Bedient dutzende parallele Anfragen, abhängig von GPU, Modell und Kontextlänge.
- Multi-GPU-Support: Hochgradig optimiertes Tensor- und Pipeline-Parallelism via NCCL.
- Ideal für: Produktive Enterprise-RAG-Plattformen, n8n-Pipelines und abteilungsweite Assistenten.
Warum PagedAttention in vLLM der Industriestandard ist
In klassischen Inferenz-Engines muss für jede Benutzeranfrage im Voraus ein zusammenhängender Block an VRAM für das maximale Kontextfenster reserviert werden. Da die tatsächliche Antwortlänge vorher unbekannt ist, verschwenden bestehende Systeme laut dem vLLM-Paper einen erheblichen Teil des KV-Cache-Speichers durch Fragmentierung. vLLM löst dieses Problem durch PagedAttention: Der dynamische KV-Cache wird in diskrete Speicherseiten (Pages) unterteilt, ähnlich dem virtuellen Speichermanagement moderner Betriebssysteme. Laut Paper steigt dadurch der Durchsatz gegenüber FasterTransformer und Orca bei gleicher Latenz um das 2- bis 4-Fache.
4. Die 4 Säulen einer sicheren Enterprise RAG-Plattform
Ein vortrainiertes Sprachmodell besitzt kein internes Wissen über Ihre spezifischen Unternehmensdaten, Artikelkataloge oder Kundenverträge. Um dieses Wissen ohne kostspieliges und veraltendes Feintuning bereitzustellen, implementieren wir eine vierstufige Enterprise RAG-Plattform (Retrieval-Augmented Generation):
Dokumenten-Parsing & Chunking
Heterogene Datenquellen (SharePoint, Netzlaufwerke, ERP-Exporte, PDFs) werden über strukturierte Parsing-Pipelines eingelesen. Tabellen und Formatierungen bleiben erhalten; semantische Chunker zerlegen Texte in logische Sinnabschnitte von 400 bis 800 Tokens.
Vektor- & Hybridspeicher
Embeddings werden in performanten Vektordatenbanken gespeichert. Entscheidend für den Unternehmenseinsatz ist Hybrid Search: Die Kombination aus semantischer Vektorsuche (Cosine Distance via HNSW) und exakter Schlagwortsuche (BM25) für Artikelnummern und DIN-Normen.
Cross-Encoder Reranking
Die Vektorsuche liefert die 25 relevantesten Treffer. Ein nachgelagertes Cross-Encoder-Reranking-Modell bewertet die Relevanz jedes Abschnitts im direkten Abgleich mit der Nutzerfrage neu und filtert Rauschen heraus. Dies verbessert die Relevanz des Kontexts und senkt damit das Halluzinationsrisiko.
RBAC & PII-Anonymisierung
Bevor Textfragmente in den LLM-Prompt injiziert werden, maskiert ein lokaler Presidio-Filter personenbezogene Daten. Gleichzeitig erzwingt die Abfrage-Engine rollenbasierte Zugriffsberechtigungen (RBAC): Mitarbeiter sehen nur Antworten aus Dokumenten, für die sie eine Freigabe besitzen.
5. Netzwerk-Integration & Orchestrierung mit n8n & MCP
Ein isolierter KI-Server entfaltet seinen vollen wirtschaftlichen Mehrwert erst dann, wenn er nahtlos in die operative Anwendungslandschaft des Unternehmens integriert wird. Hier bildet die Kombination aus selbst gehostetem n8n und dem Model Context Protocol (MCP) das ideale Bindeglied.
Die n8n-Orchestrierungs-Pipeline
Die quelloffene Automatisierungsplattform n8n fungiert als intelligenter Vermittler zwischen den Fachanwendungen und dem lokalen vLLM-Cluster:
Ereignisgesteuertes Triggering
Eingehende E-Mails, neue Dateien auf dem Firmen-Fileserver oder Statusänderungen im ERP (z. B. SAP oder proALPHA) lösen n8n-Workflows vollautomatisch über lokale Webhooks aus.
OpenAI-kompatible API-Anbindung
Da vLLM eine native, OpenAI-kompatible REST-Schnittstelle bereitstellt (/v1/chat/completions), können alle Standard-KI-Knoten in n8n ohne komplexe Anpassungen direkt auf die lokale GPU-Instanz umgeleitet werden.
Model Context Protocol (MCP) für autonome Aktionen
Über standardisierte MCP-Server erhält das lokale LLM sichere, typisierte Werkzeuge (Tools): Es kann eigenständig SQL-Abfragen auf internen Datenbanken ausführen, Lagerbestände prüfen oder Entwurfsbuchungen im ERP generieren.
Ein illustratives Szenario (kein Kundenprojekt): Trifft eine Kundenreklamation per E-Mail ein, liest n8n den Text aus, anonymisiert Kontaktdaten über lokale Regex-Filter, übergibt den Sachverhalt an das lokale Llama-3.3-Modell zur Ursachenprüfung gegen die interne Wissensdatenbank und erstellt automatisch ein Ticket im internen ERP – vollkommen isoliert im Firmen-LAN.
6. IT-Sicherheit, Air-Gapping & DSGVO-Compliance
Die physische Aufstellung eines Servers im eigenen Gebäude garantiert für sich allein noch keine vollkommene Sicherheit. Ohne sorgfältige Netzwerkhärtung drohen unbefugte Querzugriffe im internen Netz oder unbeabsichtigte Telemetrie-Abflüsse moderner Software-Frameworks.
1. Physisches & Logisches Air-Gapping
Der Inferenz-Host und die Vektordatenbank werden in einem isolierten VLAN (Demilitarisierte Zone, DMZ) betrieben. Ausgehender Internetverkehr ist per Firewall-Regel vollständig blockiert (Egress-Filterung: DROP all). Nur definierte interne IP-Adressen dürfen über mTLS auf das Inferenz-Gateway zugreifen.
2. Zero-Trust API-Gateway & Rate-Limiting
Anfragen aus Fachabteilungen erreichen den vLLM-Server niemals direkt, sondern passieren ein gehärtetes Reverse-Proxy-Gateway (z. B. Caddy als Reverse Proxy vor einem LiteLLM-Gateway). Dieses prüft Bearer-Tokens, erzwingt Abteilungs-Quotas und protokolliert alle Interaktionen für IT-Sicherheitsaudits.
3. Dynamische ACL-Synchronisation
Ein RAG-System darf niemals Firmengeheimnisse an unbefugte Mitarbeiter ausplaudern. Über regelmäßige Cron-Jobs werden Zugriffsrechte aus dem Windows Active Directory oder OpenLDAP in die Metadaten-Filter der Vektordatenbank synchronisiert.
4. EU AI Act & NIS-2-Risikomanagement
Durch den rein internen Betrieb ohne biometrische Erkennung oder unzulässige Scoring-Verfahren lässt sich ein lokales RAG-System in der Regel in die Kategorie „Minimales Risiko“ nach dem EU AI Act einordnen (im Einzelfall zu prüfen). Auch dann gelten die Pflicht zur KI-Kompetenz (Art. 4) und Transparenzpflichten für Chatbots (Art. 50). Für NIS-2-betroffene Betriebe reduziert der On-Premise-Betrieb das Lieferkettenrisiko externer Cloud-Provider. Zugriffe nach US CLOUD Act sind weitgehend ausgeschlossen, sofern keine US-Dienstleister Zugriff haben (Support, Telemetrie, Updates).
Vertiefende Details zur Härtung von Schnittstellen und Authentifizierungs-Layern finden Sie in unserem gesonderten Leitfaden zur Zero-Trust-Sicherheit in Automatisierungen.
7. 5-Schritte-Roadmap: Vom PoC zum produktiven On-Premise LLM
Um ein unternehmenseigenes Inferenz- und RAG-Cluster sicher, termin- und budgetgerecht in den Produktivbetrieb zu überführen, setzt Pragma-Code auf einen fünfstufigen Implementierungsplan:
-
1. Bedarfsanalyse, Modell-Auswahl & VRAM-Dimensionierung
Präzise Definition der Anwendungsfälle (Dokumenten-Q&A, Code-Generierung, Kundenkommunikation) und Schätzung der Concurrency. Auswahl der Zielarchitektur (z. B. Llama 3.3 70B AWQ) und Festlegung des exakten VRAM- und Hardwarebedarfs.
-
2. Serverraum-Infrastruktur & Hardware-Bereitstellung
Prüfung der elektrischen Absicherung, USV-Kapazitäten und Kühlung im Firmen-Serverraum. Aufbau des GPU-Servers (19-Zoll-Rackmount oder Workstation-Cluster) und Installation des gehärteten Linux-Betriebssystems (Ubuntu Server LTS mit aktuellen NVIDIA-Treibern und CUDA).
-
3. Bereitstellung des Software-Stacks (vLLM & Qdrant)
Containerisiertes Deployment von vLLM via Docker oder Kubernetes, Konfiguration von PagedAttention und Tensor-Parallelism. Aufsetzen der Vektordatenbank (Qdrant oder PostgreSQL/pgvector) und Anbindung der Ingestion-Pipelines für Unternehmensdokumente.
-
4. Netzwerkhärtung, Presidio-Filter & IAM-Integration
Einbindung des Inferenz-Hosts in die firmeninterne DMZ, Sperrung des ausgehenden Datenverkehrs (Air-Gapping). Konfiguration des Presidio-Anonymisierungs-Proxys und Anbindung an das Active Directory zur Durchsetzung bestehender Dateiberechtigungen.
-
5. Pilotbetrieb, Benchmark-Validierung & Rollout
Stresstests unter realer Mehrbenutzerlast zur Messung von Time-to-First-Token (TTFT) und Generierungsgeschwindigkeit (Tokens/s). Schulung der internen IT-Administratoren, Anbindung an n8n-Workflows und Freigabe für die Fachabteilungen.
8. Quick-Check & Strategisches Fazit
Die Entscheidung für ein eigenes On-Premise LLM ist weit mehr als eine reine Kostenabwägung: Sie ist die strategische Grundlage für echte digitale Unabhängigkeit, kompromisslose IT-Sicherheit und die langfristige Innovationsfähigkeit im KI-Zeitalter.
Quick-Check: Ist Ihr Unternehmen bereit für ein On-Premise LLM?
Unternehmen, die ihre kognitiven Kernprozesse auf eigener Infrastruktur verankern, bauen sich einen dauerhaften Schutzschild gegen regulatorische Unsicherheiten, Preisdiktate von Cloud-Monopolisten und Datenabflüsse auf. Mit der richtigen Kombination aus quantisierten Open-Weight-Modellen, vLLM als performanter Inferenz-Engine und robuster Netzwerk-Segmentierung verwandelt Pragma-Code bestehende Firmen-Hardware in hocheffiziente KI-Kraftwerke.
Offizielle Quellen & Primärdokumentation
- Kwon et al. (2023): „Efficient Memory Management for Large Language Model Serving with PagedAttention“ – Paper (arXiv) zu PagedAttention und zum Durchsatzvergleich mit FasterTransformer und Orca.
- NVIDIA: GeForce RTX 4090 – Technische Daten (24 GB GDDR6X, 1.008 GB/s, PCIe 4.0 x16).
- DeepSeek-AI: Model Card DeepSeek-V3 – 671 Mrd. Parameter (Mixture-of-Experts, 37 Mrd. aktiv).
- Ollama: FAQ – Parallele Anfragen über
OLLAMA_NUM_PARALLEL. - Europäisches Parlament & Rat (2024): „Verordnung (EU) 2024/1689 (EU AI Act)“ – Risikoklassifizierung, Pflichten für Betreiber (u. a. KI-Kompetenz nach Art. 4, Transparenz nach Art. 50) und Dokumentationsanforderungen bei generativen KI-Systemen.
Planen Sie die Einführung eines On-Premise LLMs in Ihrem Unternehmen?
Kostenlose Architektur-Erstberatung vereinbarenUnsere Expertise vor Ort
Wir sind Ihr digitaler Partner – regional verankert und überregional erfolgreich.
KI-Automatisierung für Ihr Unternehmen?
Ich setze das für kleine und mittlere Unternehmen um: zum vorab vereinbarten Festpreis und direkt mit dem, der es baut. Ablauf, Umfang und Preise stehen auf der Leistungsseite.
Leistung & Preise ansehen Oder kostenloses Erstgespräch anfragenErweitertes Fachglossar
vLLM
Hochperformante Open-Source-Inferenz-Engine für LLMs mit speichereffizienter PagedAttention-Architektur und kontinuierlichem Batching für Multi-User-Lasten.
Continuous Batching
Dynamisches Batching-Verfahren auf Token-Iterationsebene, das eingehende Anfragen sofort in laufende Berechnungen einbindet und GPU-Leerlaufzeiten verringert.
Small Data Center
Kompakte, unternehmenseigene Serverraum-Infrastruktur (19-Zoll-Racks, USV, Kühlung), die hochgradig geschützte Rechenkapazitäten im eigenen Firmennetzwerk bereitstellt.
Air-Gapped
Sicherheitsarchitektur, bei der geschäftskritische IT- und Inferenz-Systeme physisch oder logisch vollständig vom öffentlichen Internet getrennt betrieben werden.
Reranking
Zweistufige semantische Dokumentensuche, bei der ein spezialisiertes Cross-Encoder-Modell die Vektor-Kandidaten nach Relevanz neu priorisiert, um das Halluzinationsrisiko zu senken.